Dreaming: o que a Anthropic descobriu sobre memória de agentes (e o que muda no seu harness)
Memória de agentes de IA é o conhecimento que o agente acumula com a experiência e carrega de uma sessão para a outra, fora dos pesos do modelo. E o problema dela não é só esquecer. É lembrar demais. E lembrar errado.
Num experimento da Anthropic, o Sonnet 3.7 jogando Pokémon Red chegou a 413 arquivos de memória espalhados em 225 pastas, quase um milhão de caracteres de anotação. Resultado: uma insígnia. Em um trecho de 17 passos ele criou seis arquivos, apagou nove e não apertou um botão do jogo.
O artigo The components of agent memory, publicado pela Anthropic em 6 de novembro de 2026, é o estudo mais completo que eu já vi sobre o assunto. Ele separa a memória em camadas, mede o que funciona com benchmark e apresenta o dreaming: o agente "dorme", relê o que fez e conserta a própria memória.
Neste post você vai entender as quatro camadas, o que os números dizem sobre como instruir o agente, quando um wiki vale mais que busca, e como aplicar isso hoje, na API e no Claude Code.
TL;DR
- O que é: modelo de memória de agente em 4 camadas (transcript, notas, representações, contexto injetado) mais uma etapa offline de reflexão chamada dreaming.
- Stack/Modelos: Claude Managed Agents (Memory Stores + Dreams), Claude Code (auto memory). Testado de Sonnet 3.7 a Opus 5.5.
- Custo/Acesso: Memory Stores em beta. Dreams em research preview, cobrado na tarifa normal de tokens do modelo escolhido. Nenhum dos dois é elegível a ZDR/HIPAA.
- Link útil: artigo original e docs de Dreams.
As 4 camadas da memória de agentes de IA
Primeiro, o que não é memória nesse modelo. A Anthropic deixa de fora três coisas: mudança nos pesos do modelo, aprendizado dentro de uma única conversa (in-context) e compaction, aquele resumo que substitui turnos antigos.
Memória, aqui, é conhecimento que o agente ganha com a experiência e que sobrevive entre sessões como contexto que ele pode ler depois.
A inspiração é o cérebro. O hipocampo grava experiências rápido e, no descanso, reprocessa e consolida o que importa na memória de longo prazo. O agente faz o equivalente: escreve logs durante o trabalho e, offline, transforma esses logs em conhecimento organizado.
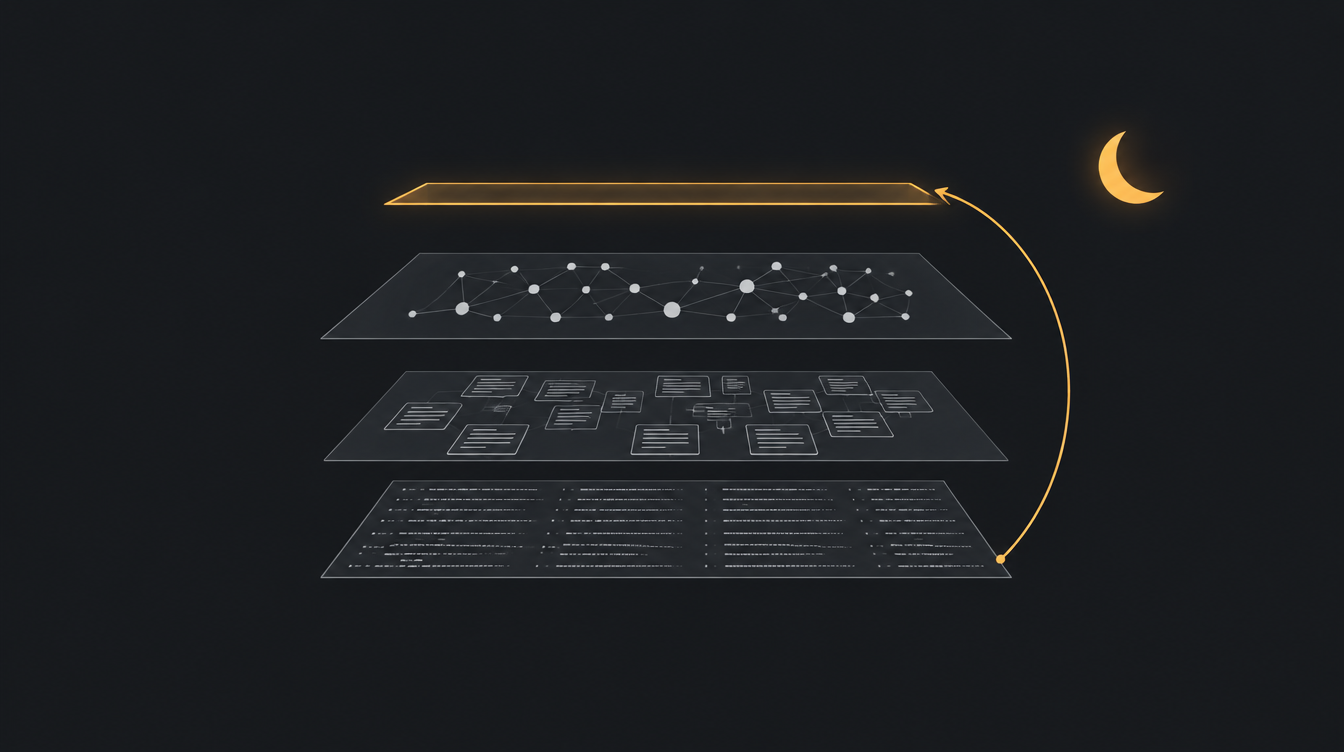
O diagrama do artigo, de baixo para cima:
┌──────────────────────────────────────────────┐
│ 4. Contexto injetado  → carregado em TODA     │  ▲
│    sessão (ex.: CLAUDE.md, MEMORY.md)         │  │
├──────────────────────────────────────────────┤  │
│ 3. Representações     → wiki com páginas      │  │  DREAMING
│    por assunto e links entre elas             │  │  corrige, cria,
├──────────────────────────────────────────────┤  │  promove e
│ 2. Notas de memória   → observações salientes │  │  rebaixa
│    escritas pelo agente durante a sessão      │  │
├──────────────────────────────────────────────┤  │
│ 1. Transcripts        → log de eventos        │──┘
│    buscável (a fonte da verdade)              │
└──────────────────────────────────────────────┘
Cada camada para cima é mais barata de consultar e mais cara de manter correta. O transcript é a verdade bruta, mas ninguém relê 400 mil linhas de log. O contexto injetado é lido de graça em toda sessão, mas se estiver errado, o erro vai junto para todas.
E aqui está a frase que reorganiza tudo: "Memory is, occasionally, a prediction." Toda nota que o agente escreve é uma aposta de que aquela informação vai ser relevante e confiável no futuro. Aposta pode dar errado.
O que os números mostram sobre instruir a memória
A Anthropic rodou o CL-Bench 1.0 num cenário de banco de dados: 30 perguntas, uma sessão nova por pergunta, e um diretório de memória persistente como único estado compartilhado. Recompensa média, sem memória vs com memória:
| Modelo | Sem memória | Com memória |
|---|---|---|
| Opus 5.5 | 0,655 | 0,838 |
| Sonnet 5.5 | 0,644 | 0,833 |
| Opus 5 | 0,564 | 0,828 |
| Opus 4.7 | 0,383 | 0,700 |
| Sonnet 5 | 0,306 | 0,610 |
| Sonnet 4.6 | 0,330 | 0,364 |
Repare no Sonnet 4.6. A memória quase não ajudou. O motivo: ele lia a própria memória antes de responder menos da metade das vezes. O Sonnet 5 lia em 9 de cada 10, sem ninguém pedir.
Quando adicionaram uma instrução explícita mandando ler a memória e testar as hipóteses, o Sonnet 4.6 foi de 0,364 para 0,641. Quase dobrou.
Agora o dado contraintuitivo. Uma regra fixa do tipo "registre só as falhas" piorou o ganho da memória nos modelos fortes: −0,234 no Opus 5, −0,150 no Opus 4.7. No Sonnet 4.6, praticamente nada (−0,020).
A conclusão da Anthropic cabe numa linha: diga ao agente para que serve a memória, não como usá-la. Modelo antigo precisa de mão firme. Modelo novo trava com regra demais. É o mesmo padrão que a gente já viu em harness minimalista para modelo novo.
Saber calibrar isso é decisão de arquitetura, e muda a cada geração de modelo. Esse tipo de ajuste a gente testa toda semana, ao vivo, no Clã Beer and Code: harness rodando, memória quebrando, gente comparando resultado em vez de opinião.
O que vale guardar: saliência
O Pokémon volta aqui. O Sonnet 3.7 anotava dinheiro e posição no mapa, coisas que a tela já mostra. Num jogo em que o estado muda o tempo todo, isso é ruído que envelhece em segundos.
O Claude Fable 5, na mesma marca de ~10 mil passos, ficou com 10 arquivos e 43 mil caracteres. E quatro insígnias. Ele guardava estratégia, planos e regras: coisas que só existem se o agente as deduzir. Depois de sete Poké Balls falhando num Magikarp, escreveu uma regra para variar o timing após três falhas seguidas. A captura seguinte deu certo. O Opus 5.5 manteve uma pastinha enxuta com objetivo e próximos passos, e zerou o jogo.
Regra prática: memória boa guarda o que é caro de redescobrir, não o que é fácil de olhar.
Dreaming: por que o agente precisa "dormir"
Nota errada não fica quieta. Ela vira armadilha.
No teste do Mt. Moon, o Claude anotou que o Centro Pokémon ficava no lado leste da montanha. Estava errado. Depois de cair de uma borda de mão única, ele leu a própria nota, concluiu que tinha "passado muito para oeste" e voltou pelo caminho errado. Três vezes. Nunca chegou a Cerulean City.
Com a memória corrigida por dreaming, a mesma corrida chegou a Cerulean na ação 1.935. A corrida sem memória nenhuma também não chegou. Ou seja: memória errada foi tão ruim quanto não ter memória.
Dreaming é a etapa offline que conserta isso. O agente relê transcripts (a fonte da verdade) e:
- corrige notas que o log contradiz;
- cria notas que deveriam ter sido escritas;
- constrói representações, como um wiki;
- promove o que é muito usado para o contexto injetado, e rebaixa detalhe para as camadas de baixo, deixando um link.
A vantagem é tirar o trabalho de organizar memória do meio da tarefa. Anotar em tempo real disputa atenção com o trabalho principal. Dormir resolve isso, com o custo de que a memória nova não fica disponível na hora. É a mesma ideia do sleep-time compute da Letta com Berkeley, agora como produto.
Não só acompanhe as novidades — domine. Engenharia de IA na prática, ao vivo, toda semana, na maior comunidade do Brasil.
Entrar no ClãWiki vs busca: quando a representação compensa
A terceira camada é a mais cara. A Anthropic testou se vale o custo.
Num corpus da Stainless com cerca de 350 mil arquivos (~420 milhões de tokens), agentes Opus 5 construíram um wiki ao longo de 128 sessões de dreaming. Em 25 perguntas:
- Só wiki: de 13% para 48% dos critérios atendidos, crescendo com mais dreaming. O wiki foi de 103 páginas e 766 links para 222 páginas e 12.893 links.
- Só busca: 53%.
- Wiki + busca: 61%, gastando ~20 mil tokens a menos por pergunta.
No Harvey LAB, em 24 perguntas de fusão e aquisição que exigem juntar vários documentos, julgamento ou conta, o wiki acertou 87% contra 73% da busca.
Mas não é bala de prata. Numa tarefa em que quase todo critério era achável com busca textual num documento só, o wiki não trouxe ganho claro. E num corpus pequeno (10 documentos, 115 KB), o wiki ficou 1,77 vez maior que o próprio corpus.
O caso mais útil para quem vai construir é o dos contratos. Quatro agentes escrevendo ao mesmo tempo numa tabela compartilhada: só 41 de 57 fatos sobreviveram (72%), porque um sobrescrevia o outro. Trocando para uma página por contrato, citando os termos literalmente: 57 de 57.
A lição de arquitetura é velha conhecida de qualquer dev backend: estado compartilhado com escrita concorrente dá corrida. Um dono por entidade resolve.
A recomendação da Anthropic: busca no transcript como fundação, representação por cima quando a pergunta exige síntese.
Mão na massa: memória e dreaming na prática
Pré-requisitos
- [ ] Chave da API da Anthropic com acesso a Claude Managed Agents
- [ ] Para Dreams: acesso ao research preview (pedido pelo formulário oficial)
- [ ] SDK Python da Anthropic atualizado
- [ ] Para o passo 3: Claude Code instalado
Passo 1: crie um memory store e anexe à sessão
O Memory Store é uma coleção de documentos de texto montada como diretório no sandbox. O agente lê e escreve com as ferramentas de arquivo normais, e cada mudança gera uma versão imutável.
from anthropic import Anthropic

client = Anthropic()

store = client.beta.memory_stores.create(
    name="User Preferences",
    description="Per-user preferences and project context.",
)

client.beta.memory_stores.memories.create(
    store.id,
    path="/formatting_standards.md",
    content="All reports use GAAP formatting. Dates are ISO-8601...",
)

session = client.beta.sessions.create(
    agent=agent.id,
    environment_id=environment.id,
    resources=[
        {
            "type": "memory_store",
            "memory_store_id": store.id,
            "access": "read_write",
            "instructions": "User preferences and project context. Check before starting any task.",
        }
    ],
)
Repare no campo instructions: ele diz para que serve a memória, e não como usar. Exatamente o que o benchmark recomenda.
Dois cuidados da doc. O store só é anexado na criação da sessão, e são no máximo 8 por sessão. E se o agente lê conteúdo não confiável (web, e-mail, ticket de cliente), um store read_write vira porta para prompt injection persistente: a sessão seguinte confia no que foi gravado. Para material de referência, use "access": "read_only".
Nas chamadas cURL, os headers mudam: endpoints de memory store usam anthropic-beta: agent-memory-2026-07-22, e sessões usam managed-agents-2026-04-01. Mandar os dois juntos numa chamada de memory store dá 400.
Passo 2: rode um dream sobre as sessões
O dream é um job assíncrono. Recebe um memory store e de 1 a 100 sessões passadas, e devolve um store novo, reorganizado. O original nunca é modificado, então dá para comparar antes e depois.
import time

dream = client.beta.dreams.create(
    inputs=[
        {"type": "memory_store", "memory_store_id": store_id},
        {"type": "sessions", "session_ids": [session_a, session_b]},
    ],
    model="claude-opus-5-5",
    instructions="Focus on coding-style preferences; ignore one-off debugging notes.",
)

while dream.status in ("pending", "running"):
    time.sleep(10)
    dream = client.beta.dreams.retrieve(dream.id)
    print(f"status={dream.status} input_tokens={dream.usage.input_tokens}")

output_store_id = next(
    output.memory_store_id for output in dream.outputs if output.type == "memory_store"
)

session = client.beta.sessions.create(
    agent=agent_id,
    environment_id=environment_id,
    resources=[
        {"type": "memory_store", "memory_store_id": output_store_id},
    ],
)
Dica que a própria doc dá: instructions direciona a síntese como um todo ("foque em X, ignore Y"). Ordem cirúrgica do tipo "troque a frase X por Y" geralmente não faz nada. Para edição pontual, use a API de memories direto no store de saída.
Erros comuns: arquivar o store ou apagar uma sessão de entrada enquanto o dream roda derruba o job (input_memory_store_unavailable, input_session_unavailable). Dream que falha ou é cancelado deixa o store de saída com conteúdo parcial, então não promova esse store para produção sem olhar. E o tempo varia de minutos a algumas horas.
Passo 3: aplique as camadas no Claude Code hoje
Você não precisa de Managed Agents para usar as ideias. O Claude Code já tem as camadas:
- Contexto injetado:
CLAUDE.md(você escreve) e oMEMORY.mdda auto memory (o Claude escreve), em~/.claude/projects/<projeto>/memory/. - Notas: um arquivo por memória nessa pasta, lido sob demanda.
- Transcripts: o histórico das sessões.
O detalhe que muda tudo: do MEMORY.md, só as primeiras 200 linhas ou 25 KB são carregadas no início da sessão. Ele é um índice, não um depósito. Uma linha por memória, apontando para o arquivo com o detalhe. Isso é a camada 4 pequena e a camada 2 grande, exatamente como o artigo recomenda.
Dreaming automático não existe no Claude Code. Mas a ideia funciona manual. Este é um prompt meu, não da Anthropic, que eu rodo de tempos em tempos numa sessão dedicada:
Revise a pasta de memória deste projeto como uma etapa de "dreaming".

1. Para cada memória, verifique no código e no git log se ainda é verdade.
   Corrija ou apague o que estiver desatualizado.
2. Junte memórias duplicadas ou que falam do mesmo assunto.
3. Mantenha o MEMORY.md como índice: uma linha por memória, bem abaixo de 200 linhas.
   Detalhe vai para o arquivo da memória, não para o índice.
4. Não invente memória nova sem evidência no código ou no histórico.

No fim, liste o que mudou e por quê.
O item 1 é o que importa. É o equivalente a checar a nota contra o transcript: a verdade está no código e no histórico, não no que o agente achou um mês atrás.
Limitações e pontos de atenção
- Memória errada contamina tudo. Nota incorreta no contexto injetado vai para toda sessão. O Mt. Moon mostrou que isso pode ser pior que não ter memória.
- Dreaming custa token. O custo cresce mais ou menos linearmente com número e tamanho das sessões. A própria Anthropic admite que checar toda memória o tempo todo "might not be practical" e sugere focar no que muda mais ou no que é mais acessado.
- Wiki também alucina. Representação precisa de compute para continuar correta. Sem manutenção, acumula erro com cara de documentação oficial.
- Carregar não é obedecer. Memória injetada gasta token e não garante que o modelo aja de acordo. Arquivo de instrução longo derruba a aderência.
- Evidência anedótica em parte. As comparações de Pokémon são uma corrida por modelo. CL-Bench e Harvey são tarefas específicas. Não generalize os percentuais para o seu domínio sem medir.
- Privacidade. Memory Stores e Dreams não são elegíveis a ZDR nem HIPAA. Dado sensível de cliente não entra aí sem decisão consciente.
FAQ
Dreaming é fine-tuning?
Não. Nenhum peso do modelo muda. Dreaming é o próprio Claude lendo transcripts e reescrevendo arquivos de memória. O resultado é texto que vai para o contexto das próximas sessões, auditável e versionado. Se der errado, você volta para o store anterior, que o dream nunca altera.
Funciona fora do Managed Agents?
A API de Dreams é do Managed Agents. Mas o padrão é portável: qualquer harness que guarde transcripts e uma pasta de notas pode rodar um job periódico que relê os logs e corrige as notas. Para a parte de notas em arquivo, veja sistema de arquivos como memória do agente.
Quanto custa um dream?
Tarifa padrão de tokens do modelo que você escolher, sem preço à parte. O campo usage do recurso traz o total exato de tokens de entrada, saída e cache. Comece com poucas sessões e um modelo menor para medir antes de escalar.
Preciso de banco vetorial para memória de agente?
Não necessariamente. O artigo inteiro trabalha com arquivos, busca em transcript e wiki com links. Vetor ajuda na busca semântica de fatos entre conversas, mas não resolve memória errada nem memória inchada. Para quando ele faz sentido, veja pgvector como memória do seu agente.
Conclusão
O artigo da Anthropic troca a pergunta "como dar memória ao agente" por uma melhor: como manter essa memória pequena e correta ao longo do tempo.
A resposta tem três partes. Camadas, com o topo enxuto e o transcript como verdade. Instrução de propósito, não de procedimento. E uma etapa offline que relê, corrige e reorganiza.
O próximo passo dessa tecnologia é óbvio: dreaming com cadência adaptativa, rodando mais onde a memória muda mais. Até lá, comece pelo básico: entenda por que o agente esquece tudo e trate seu MEMORY.md como índice, não como diário.
{AI Engineer} — apaixonado por Laravel, arquitetura de software e construir produtos com impacto. Compartilho aqui tutoriais, descobertas e reflexões sobre o dia a dia de engenharia.
Conteúdo é o que não falta. Falta quem desembaralhe: o que importa agora é como implementar do jeito certo. No Clã você tem isso ao vivo, toda semana, com quem já filtrou o ruído.
Entrar no Clã