Sistema de arquivos como memória do agente: progress file, feature list e git log na prática
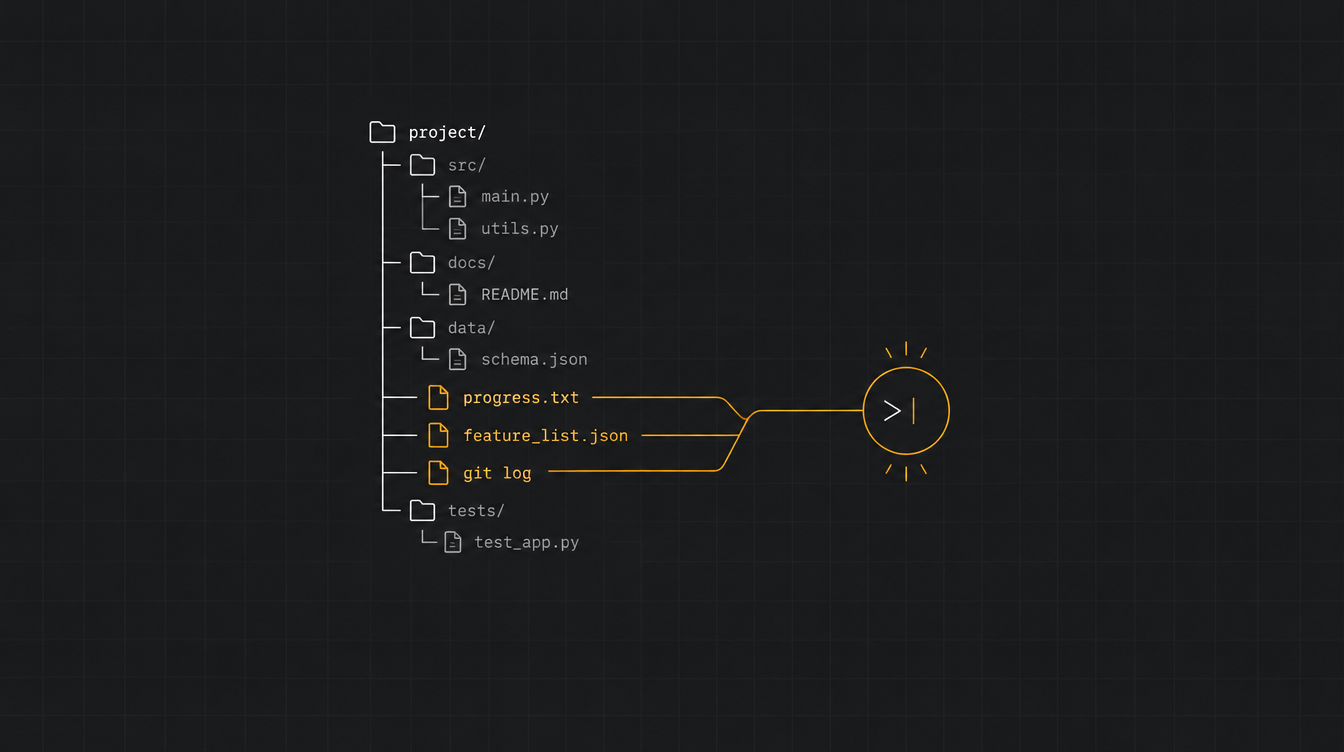
Usar o sistema de arquivos como memória do agente é tirar o estado da tarefa de dentro da janela de contexto e colocar em arquivos que o próprio agente lê e escreve: um arquivo de progresso, uma lista de funcionalidades em JSON, o histórico do git. A janela vira memória de curto prazo. O disco vira a memória que sobrevive.
Parece pouco. Não é.
Todo agente que roda por mais de uma janela de contexto bate no mesmo muro: a sessão nova começa sem lembrar nada da anterior. A Anthropic descreve isso como um projeto tocado por engenheiros em turnos, onde cada um chega sem saber o que o turno anterior fez.
Neste tutorial você vai montar, em PHP, as quatro peças que resolvem isso: o arquivo de progresso, a feature list em JSON, o ritual de início de sessão e o offload de resultado grande de ferramenta para arquivo.
TL;DR
- O que é: padrão de harness em que o estado do agente mora em arquivos (progresso, plano, resultados grandes), não na conversa.
- Stack: qualquer loop de agente com ferramentas de ler e escrever arquivo e rodar shell. Exemplos em PHP 8.3 / Laravel.
- Custo/Acesso: zero de infraestrutura nova. É disco, JSON e git.
- Referência principal: Effective harnesses for long-running agents, da Anthropic.
Por que a janela de contexto não serve de memória
Janela grande não resolve. Ela só adia o problema.
O post de context engineering da Anthropic é direto: janelas de qualquer tamanho sofrem com poluição de contexto e relevância de informação. A saída que eles listam para tarefas longas tem três técnicas: compactação, anotação estruturada (o agente escreve notas fora da janela e relê depois) e subagentes.
A compactação sozinha não segura. No experimento de agentes de longa duração, a Anthropic rodou o Claude no Agent SDK, com compactação ligada, pedindo para construir um clone do claude.ai. Duas falhas apareceram:
- O agente tentava fazer tudo de uma vez. Estourava o contexto no meio de uma feature e a próxima sessão herdava código pela metade, sem documentação.
- O agente declarava vitória cedo. Uma sessão posterior olhava em volta, via que muita coisa já existia e dava o projeto por terminado.
A Manus chegou na mesma conclusão por outro caminho. No post sobre context engineering da Manus, o sistema de arquivos é tratado como "o contexto definitivo": tamanho ilimitado, persistente por natureza e operável pelo próprio agente.
O ponto que costuma passar batido: isso não é só armazenamento. O agente decide o que escrever, quando reler e o que jogar fora da janela. É memória gerenciada pelo próprio modelo.
Se você quer ver esse padrão montado na frente de você, com o agente perdendo a sessão e voltando ao trabalho lendo os próprios arquivos, é um dos blocos práticos do AI Engineering Lab 4ª Edição, imersão de Harness Engineering ao vivo nos dias 14 e 15 de novembro, das 9h às 13h.
Sistema de arquivos como memória do agente: as quatro peças
Antes do código, o mapa:
| Peça | Arquivo | Função |
|---|---|---|
| Diário de progresso | progress.md |
o que foi feito, o que quebrou, o que vem depois |
| Feature list | feature_list.json |
o escopo inteiro, com status passes por item |
| Histórico | git log |
o que mudou de fato e um ponto de volta seguro |
| Resultados grandes | .agent/tool_results/*.txt |
saída de ferramenta que não cabe na janela |
As três primeiras vêm direto do harness da Anthropic. A quarta é o que a Manus chama de compressão restaurável e o que o Deep Agents da LangChain faz automaticamente em /large_tool_results/.
Pré-requisitos
- [ ] Um loop de agente que você controla. Se ainda não tem, comece pelo primeiro harness em Laravel.
- [ ] Ferramentas de ler arquivo, escrever arquivo e rodar shell expostas ao modelo.
- [ ] Git no diretório de trabalho do agente.
- [ ] PHP 8.3+.
Tutorial te mostra o caminho — no Clã você constrói junto. Aula ao vivo toda semana, projetos reais de Engenharia de IA, ao lado de quem já está em produção.
Entrar no ClãMão na massa: memória do agente em arquivo, passo a passo
Passo 1: a feature list em JSON
O primeiro problema é o agente que acha que terminou. A cura da Anthropic: uma sessão inicial (o "agente inicializador") expande o pedido do usuário numa lista exaustiva de funcionalidades. No clone do claude.ai foram mais de 200 itens, todos começando como falhando.
O formato que eles publicaram:
{
  "category": "functional",
  "description": "New chat button creates a fresh conversation",
  "steps": [
    "Navigate to main interface",
    "Click the 'New Chat' button",
    "Verify a new conversation is created",
    "Check that chat area shows welcome state",
    "Verify conversation appears in sidebar"
  ],
  "passes": false
}
Detalhe que vale ouro: eles escolheram JSON em vez de Markdown porque o modelo tem menos tendência a reescrever ou sobrescrever indevidamente um arquivo JSON. E o prompt proíbe editar qualquer coisa além do campo passes.
Proibir no prompt é bom. Garantir no harness é melhor. Esse guard roda depois de cada escrita do agente e rejeita qualquer mudança que não seja no passes:
<?php

namespace App\Agent\Memory;

use RuntimeException;

final class FeatureListGuard
{
    /**
     * Compara a versão anterior com a nova e só aceita mudança no campo "passes".
     */
    public function assertOnlyStatusChanged(string $before, string $after): void
    {
        $old = json_decode($before, true, flags: JSON_THROW_ON_ERROR);
        $new = json_decode($after, true, flags: JSON_THROW_ON_ERROR);

        if (count($old) !== count($new)) {
            throw new RuntimeException('Agente adicionou ou removeu features. Rejeitado.');
        }

        foreach ($old as $i => $feature) {
            $strip = fn (array $f) => array_diff_key($f, ['passes' => true]);

            if ($strip($feature) !== $strip($new[$i])) {
                throw new RuntimeException("Feature #{$i} foi editada além do status. Rejeitado.");
            }
        }
    }
}
O agente pode marcar passes: true. Não pode apagar o teste chato que não passa. Essa é a diferença entre regra no prompt e regra no código.
Passo 2: o diário de progresso
O segundo arquivo é o diário. No experimento da Anthropic ele se chama claude-progress.txt e, junto com o git, é o que permite a uma sessão nova entender rápido o estado do trabalho.
O formato é livre, mas estrutura ajuda o próximo turno a ler rápido:
# progress.md

## Sessão 2026-11-06 10:42
- Feature trabalhada: #14 "Usuário renomeia conversa"
- Status: passa no teste end-to-end
- Commit: 3f9c2a1
- Observação: o modal de rename usa alert nativo, teste via browser não enxerga

## Próximo passo sugerido
- Feature #15 "Usuário apaga conversa"
- Antes: rodar ./init.sh e o smoke test, o build quebrou duas vezes hoje
A regra de fim de sessão vem junto: um commit descritivo e uma entrada no diário. A Anthropic relata que isso deixou o agente usar o git para reverter mudança ruim e recuperar estados que funcionavam.
Passo 3: o ritual de início de sessão
Com os arquivos no lugar, toda sessão nova começa do mesmo jeito. A lista da Anthropic é quase constrangedora de tão simples:
pwdpara saber onde está.- Ler o git log e o arquivo de progresso.
- Ler a feature list e escolher uma feature, a de maior prioridade que ainda não passa.
- Rodar o
init.sh, subir o servidor e fazer um teste básico antes de mexer em qualquer coisa.
O passo 4 importa mais do que parece. Se a sessão anterior deixou o app quebrado, começar feature nova só piora.
Você pode deixar o modelo fazer isso sozinho via prompt, ou adiantar o trabalho no harness e entregar o resumo pronto na primeira mensagem:
<?php

namespace App\Agent\Memory;

use Illuminate\Support\Facades\Process;

final class SessionBootstrap
{
    public function __construct(private string $workdir) {}

    public function briefing(): string
    {
        $progress = $this->tail("{$this->workdir}/progress.md", 60);
        $gitLog   = Process::path($this->workdir)->run('git log --oneline -20')->output();
        $features = json_decode(file_get_contents("{$this->workdir}/feature_list.json"), true);

        $pending = array_filter($features, fn ($f) => $f['passes'] === false);
        $next    = array_key_first($pending);
        $total   = count($features);
        $done    = $total - count($pending);

        return <<<TXT
        Você está retomando um trabalho em andamento. Não comece do zero.

        Progresso: {$done}/{$total} features passando.
        Próxima feature (#{$next}): {$features[$next]['description']}

        Últimos commits:
        {$gitLog}

        Diário recente:
        {$progress}

        Antes de implementar: rode ./init.sh e o smoke test. Se algo estiver quebrado, conserte primeiro.
        Trabalhe em UMA feature. Ao terminar: commit descritivo e nova entrada em progress.md.
        TXT;
    }

    private function tail(string $path, int $lines): string
    {
        return implode("\n", array_slice(file($path, FILE_IGNORE_NEW_LINES), -$lines));
    }
}
Repare no que isso faz com o custo. O agente não gasta dez chamadas de ferramenta descobrindo onde parou. Gasta zero.
Passo 4: offload de resultado grande para arquivo
A quarta peça é a que mais economiza token no dia a dia. Ferramenta que devolve página web, PDF, log de CI ou resultado de query grande enche a janela em duas chamadas.
A Manus formaliza a regra: compressão tem que ser restaurável. O conteúdo de uma página pode sair do contexto desde que a URL fique. O conteúdo de um documento pode sair desde que o caminho do arquivo fique.
Na prática, um middleware no seu loop:
<?php

namespace App\Agent\Memory;

use Illuminate\Support\Str;

final class ToolResultOffloader
{
    public function __construct(
        private string $dir,
        private int $maxChars = 8_000,
    ) {}

    public function handle(string $toolName, string $output): string
    {
        if (mb_strlen($output) <= $this->maxChars) {
            return $output;
        }

        $path = sprintf('%s/%s-%s.txt', $this->dir, $toolName, Str::ulid());
        file_put_contents($path, $output);

        $preview = mb_substr($output, 0, 1_500);
        $lines   = substr_count($output, "\n") + 1;

        return <<<TXT
        [resultado grande salvo em {$path} ({$lines} linhas)]
        Prévia:
        {$preview}
        ...
        Use read_file com offset/limit ou grep nesse caminho para ler o resto.
        TXT;
    }
}
O modelo recebe uma prévia e um ponteiro. Se precisar do resto, lê em pedaços. É o mesmo comportamento que a Anthropic descreve no Claude Code: guardar o resultado, usar head e tail e nunca carregar o objeto inteiro na janela.
Memória virtual ou sandbox real?
Aqui mora uma decisão de arquitetura que muita gente pula. Nem todo arquivo do agente precisa estar num disco de verdade.
O Deep Agents separa isso em backends. O StateBackend é efêmero, serve de rascunho e recebe o despejo automático de resultados grandes. O FilesystemBackend escreve em disco real. E a própria documentação recomenda um CompositeBackend para que plano, notas e resultados despejados não se misturem com os arquivos do projeto.
A divisão que eu uso:
- Plano, notas e resultados grandes: armazenamento barato do harness (diretório
.agent/, tabela no banco, objeto no storage). Não precisa de sandbox. - Código que o agente executa: sandbox real, isolado. Só aqui.
- Feature list e diário de projetos de código: dentro do repositório, versionados no git junto com o código.
Misturar tudo num container só funciona no demo. Em produção, quando o container morre, o estado morre junto.
Limitações e pontos de atenção
- Arquivo de memória também é superfície de ataque. Conteúdo vindo de página web que vai parar no
progress.mdvolta para o contexto em toda sessão. É prompt injection persistente. Trate o que vem de fora como dado, não como instrução, e revise o que o agente grava. - O diário apodrece. Sem regra de tamanho,
progress.mdvira um arquivo de 3 mil linhas que ninguém lê. Leia só o final (otaildo exemplo) e peça ao agente para resumir entradas antigas de tempos em tempos. - Agente marcando
passes: truesem testar. A Anthropic viu isso acontecer: código alterado, teste de unidade rodado, feature marcada como pronta e quebrada de ponta a ponta. O arquivo não resolve verificação. Ele só torna a mentira auditável. - Escrita concorrente. Dois subagentes escrevendo no mesmo
feature_list.jsoné corrida garantida. Um dono por arquivo, ou lock. - Dado sensível no disco. Resultado de ferramenta com dado de cliente agora está em arquivo. Aplique a mesma política de retenção que você aplica a log.
FAQ
Isso substitui memória vetorial?
Não. Resolve outro problema. Memória vetorial serve para lembrar fatos do usuário entre conversas diferentes. Memória em arquivo serve para manter o estado de uma tarefa que atravessa várias janelas de contexto. Para a primeira, veja como dar memória de verdade ao seu agente.
Por que JSON e não Markdown na feature list?
Porque, nos testes da Anthropic, o modelo tende menos a reescrever ou sobrescrever indevidamente um JSON do que um Markdown. E JSON dá para validar no código, como no guard do passo 1. Markdown fica bom para o diário, que é texto livre feito para ser lido.
Preciso de framework de agente para usar esse padrão?
Não. São arquivos, um git log e meia dúzia de linhas no seu loop. Frameworks como o Deep Agents trazem o offload pronto, mas o padrão funciona em qualquer harness que exponha ler arquivo, escrever arquivo e shell ao modelo.
Funciona fora de agente de código?
A Anthropic mostra o Claude jogando Pokémon com anotações próprias: depois de cada reset de contexto, ele relê as notas e continua sequências de treino de horas. Pesquisa, migração de dados e análise longa seguem a mesma lógica.
Conclusão
A janela de contexto é memória de trabalho. É cara, finita e se degrada quando enche. O sistema de arquivos é o resto: barato, persistente e auditável.
O padrão inteiro cabe em quatro peças: feature list em JSON que só aceita mudança de status, diário de progresso, ritual de início de sessão e offload de resultado grande com ponteiro restaurável. Nenhuma exige infraestrutura nova.
O próximo passo natural é a pergunta incômoda: quem garante que o passes: true é verdade? Quando o agente marca a própria tarefa como pronta, você precisa de verificação que não dependa dele. Enquanto isso, se o seu harness ainda carrega regra demais no prompt, vale ler por que modelo novo pede menos regra e entender por que o Claude Code trava em tarefas longas.
{AI Engineer} — apaixonado por Laravel, arquitetura de software e construir produtos com impacto. Compartilho aqui tutoriais, descobertas e reflexões sobre o dia a dia de engenharia.
Conteúdo é o que não falta. Falta quem desembaralhe: o que importa agora é como implementar do jeito certo. No Clã você tem isso ao vivo, toda semana, com quem já filtrou o ruído.
Entrar no Clã