Harness minimalista: por que modelo novo pede menos regra, menos tool e menos prompt
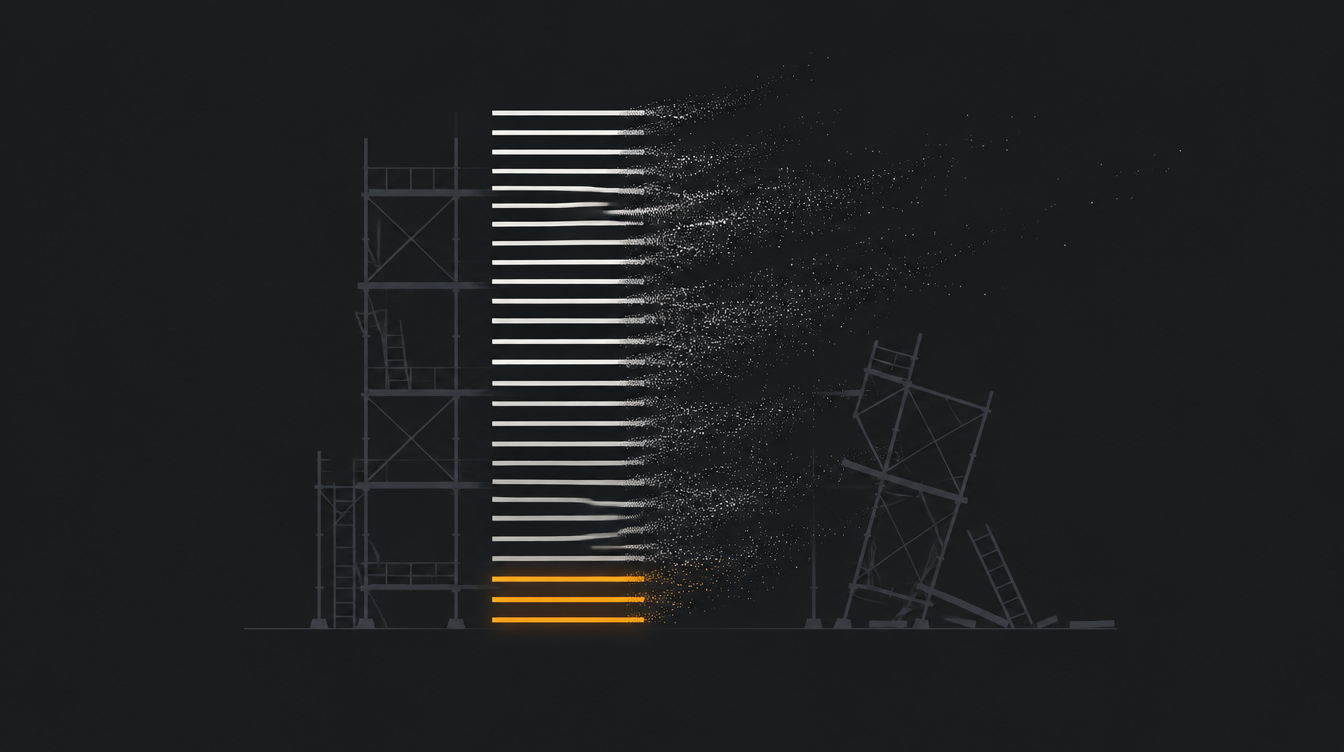
O harness que salvou seu agente no ano passado é o que está atrapalhando ele agora.
Aquele IMPORTANTE: em caixa alta. As 40 tools registradas "por via das dúvidas". O few-shot de três páginas. O roteador que obriga o agente a passar por cinco etapas fixas antes de responder. Tudo isso nasceu pra tapar buraco de um modelo específico. O modelo mudou. O remendo ficou.
Harness minimalista é a prática de manter no harness só o que o modelo atual realmente precisa, apagando regras, tools e prompts que viraram ruído a cada troca de modelo. Não é preguiça, é manutenção. Cada geração de modelo transforma a muleta do harness anterior em peso morto. Vou mostrar o que as próprias Anthropic e OpenAI mandam remover quando você troca de modelo, o que apagar primeiro e, principalmente, como provar com eval que a remoção não piorou nada.
TL;DR
- O que é: harness minimalista é a prática de reauditar prompt, tools e orquestração a cada troca de modelo, removendo o que virou ruído.
- O que remover primeiro: regras em CAPS, instruções anti-preguiça, tools redundantes, few-shot gigante e etapas fixas de orquestração.
- Base: guias oficiais de migração da Anthropic e da OpenAI, mais "The Bitter Lesson", de Rich Sutton.
- Regra de ouro: nada sai sem eval antes/depois. Nada entra de volta sem eval mostrando que faz falta.
O contexto: harness cresce por acúmulo, nunca por design
Se você precisa de um alinhamento de vocabulário, o hub do assunto aqui no blog é o que é harness em IA: o loop, as tools, o estado e os guardrails que envolvem o modelo. Este post é sobre o que acontece com esse harness com o tempo.
E o que acontece é acúmulo.
A definição de harness engineering que colou na indústria, do Mitchell Hashimoto, explica o mecanismo sem querer: toda vez que o agente erra, você engenheira uma solução pra ele nunca mais errar aquilo. A gente discutiu isso no post sobre por que harness engineering não basta. É engenharia de verdade. Mas repara no detalhe: a regra entra quando o modelo falha. Ninguém tem um processo pra tirar a regra quando o modelo para de falhar.
Resultado: o harness vira um sedimento de remendos. Cada camada foi escrita pra um modelo que você nem usa mais.
E aqui entra o problema que pouca gente percebe. Remendo antigo não é neutro. Ele não fica lá parado, inofensivo. Modelo novo segue instrução com mais fidelidade, e uma instrução escrita pra compensar a desatenção do modelo velho vira exagero no modelo novo.
Não é opinião minha. Está no guia oficial da Anthropic:
"If your prompts were designed to reduce undertriggering on tools or skills, these models might now overtrigger. The fix is to soften any aggressive language. Where you might have said 'CRITICAL: You MUST use this tool when...,' you can use more normal prompting such as 'Use this tool when...' instead." (Anthropic, Prompting best practices)
E a OpenAI, no guia de migração do GPT-5.5, é ainda mais direta: "Begin migration with a fresh baseline instead of carrying over every instruction from an older prompt stack". O motivo vem logo depois: "Legacy prompts often over-specify the process because earlier models needed more help staying on track" (OpenAI, guia do GPT-5.5).
Dois labs concorrentes, a mesma recomendação: apague antes de adicionar.
Esse tipo de reauditoria a cada lançamento é cansativo de fazer sozinho, porque o chão muda a cada trimestre. É o que a gente faz toda semana no Clã Beer and Code: agente de produção na mesa, harness, RAG e evals, discutindo o que ainda se paga e o que já virou ruído.
The Bitter Lesson aplicado a harness
Em março de 2019, Rich Sutton publicou um texto curto que todo mundo que mexe com agente deveria reler uma vez por ano. The Bitter Lesson abre assim:
"The biggest lesson that can be read from 70 years of AI research is that general methods that leverage computation are ultimately the most effective, and by a large margin."
O argumento do Sutton é sobre pesquisa: toda vez que alguém codificou conhecimento humano no sistema (regras de xadrez, heurísticas de visão), funcionou no curto prazo e perdeu no longo prazo pra métodos gerais que escalam com computação. A frase que fecha o ensaio é a que interessa pra gente: queremos agentes que consigam descobrir como nós descobrimos, não agentes que contenham o que nós já descobrimos.
Agora troca "pesquisa em IA" por "seu harness".
Cada regra hardcoded no system prompt é conhecimento humano injetado pra compensar uma limitação do modelo. Funciona. Até o próximo modelo, treinado com mais computação, resolver aquilo sozinho. Aí a sua regra para de ajudar e começa a competir com o julgamento do modelo.
Isso não significa que harness morreu. O post sobre harness engineering continua valendo: loop, estado, permissão e observabilidade são infraestrutura, não muleta. A lição amarga separa duas coisas:
- Infraestrutura: o que dá ao modelo acesso ao mundo (tools bem desenhadas, estado persistente, sandbox, limites de custo). Isso fica.
- Muleta: o que tenta pensar no lugar do modelo (regras de procedimento, ênfase em CAPS, roteiros rígidos de raciocínio). Isso expira.
Harness minimalista na prática: o que remover quando você troca de modelo
Uma lista prática, em ordem de risco crescente. Comece pelo topo.
1. Ênfase artificial: CAPS, "CRITICAL", "NUNCA", "SEMPRE"
É o remendo mais comum e o mais fácil de tirar. Ele existia porque o modelo antigo ignorava instrução no meio de um prompt longo. O modelo novo não ignora. E aí SEMPRE use a busca vira busca em toda pergunta, inclusive no "obrigado".
# Antes (escrito pra um modelo que esquecia a tool)
CRITICAL: You MUST ALWAYS call search_docs before answering.
NEVER answer from memory. If in doubt, use search_docs.

# Depois
Use search_docs when the question depends on product documentation
or on details that may have changed. Answer directly when it doesn't.
Repara que o "depois" não é só mais educado. Ele dá o critério, não a ordem. A Anthropic cita literalmente o padrão "If in doubt, use [tool]" como causa de overtriggering e recomenda trocar defaults genéricos por instruções direcionadas (fonte).
2. Instruções anti-preguiça
"Seja extremamente detalhado." "Leia todos os arquivos relevantes antes de responder." "Não pare até ter certeza absoluta." Isso era vacina contra modelo que respondia raso. No modelo atual, vira exploração excessiva, contexto inflado e conta de token maior.
O guia de migração da Anthropic tem um item só pra isso: "If your prompts previously encouraged the model to be more thorough or use tools more aggressively, reduce that guidance". Se depois de remover o modelo ainda exagerar, o ajuste recomendado é baixar o effort, não escrever mais regra.
3. Tools redundantes
Tool é contexto. Cada definição de tool ocupa espaço no prompt e adiciona uma decisão a mais pro modelo tomar a cada passo. O harness que registra get_user, get_user_by_email, get_user_orders, get_user_profile e search_users está pedindo pro modelo escolher entre cinco portas que dão no mesmo corredor.
A própria Anthropic, no guia de escrita de tools para agentes, resume: "More tools don't always lead to better outcomes". A recomendação é ter poucas tools pensadas pros fluxos de alto impacto, e consolidar operações que sempre andam juntas numa chamada só.
Na prática, pergunte de cada tool:
- O modelo chamou ela nos últimos N traces de produção?
- Ela faz algo que outra tool, com um parâmetro a mais, já faz?
- Ela existe porque o modelo antigo não sabia compor duas chamadas?
Se a resposta for "não, sim, sim", ela é candidata a sair.
4. Few-shot gigante
Exemplo é a forma mais forte de instrução que existe. Por isso mesmo é perigoso. Cinco exemplos longos ensinam formato, tom, tamanho e, de brinde, os vícios dos cinco exemplos. Modelo antigo precisava disso pra acertar o formato. Modelo atual acerta formato com uma frase ou com structured outputs.
Teste trocar o bloco de exemplos por uma descrição do contrato de saída. Se o eval aguentar, você ganhou contexto e perdeu um vetor de viés.
5. Orquestração rígida
Esse é o mais caro de mexer e o que mais rende. É o pipeline fixo: "primeiro classifique, depois planeje, depois busque, depois valide, depois responda", cada etapa uma chamada separada, com o código decidindo a ordem.
Fazia sentido quando o modelo se perdia em tarefa de vários passos. Hoje, muitas vezes, você está pagando cinco chamadas pra forçar um raciocínio que o modelo faria melhor numa só, com as tools certas na mão. A OpenAI fala exatamente disso: "Reduce or remove detailed step-by-step process guidance" (fonte).
Cuidado aqui: nem toda etapa fixa é muleta. Gate de segurança, validação de saída e checkpoint de aprovação humana são infraestrutura (são as camadas de um harness em produção). O que sai é a etapa que só existe pra dizer ao modelo como pensar.
O conselho mais antigo continua o melhor. A Anthropic, em Building effective agents, já recomendava em 2024 "finding the simplest solution possible, and only increasing complexity when needed". A parte que todo mundo esquece é que "quando necessário" muda a cada modelo.
Não só acompanhe as novidades — domine. Engenharia de IA na prática, ao vivo, toda semana, na maior comunidade do Brasil.
Entrar no ClãComo medir se a remoção piorou: eval antes e depois
Aqui está a diferença entre harness minimalista e harness desleixado. Apagar regra no feeling é tão irresponsável quanto adicionar regra no feeling.
O fluxo é este:
- Monte um dataset com casos reais (30 a 100 já dá sinal), incluindo os casos que motivaram cada regra que você quer remover.
- Rode o harness atual no modelo novo. Esse é o baseline.
- Remova uma categoria de muleta por vez.
- Rode de novo. Compare taxa de acerto, número de tool calls e tokens.
- Se piorou, a regra volta, reescrita no tom normal. Se empatou ou melhorou, ela morre.
Um esqueleto em Python, com o SDK da Anthropic, que compara dois system prompts no mesmo dataset:
import json
import anthropic

client = anthropic.Anthropic()
MODEL = "claude-opus-5-5"

TOOLS = [{
    "name": "search_docs",
    "description": "Search product documentation. Use when the answer depends on docs or recent changes.",
    "input_schema": {
        "type": "object",
        "properties": {"query": {"type": "string"}},
        "required": ["query"],
    },
}]

def run_case(system: str, case: dict) -> dict:
    resp = client.messages.create(
        model=MODEL,
        max_tokens=1024,
        system=system,
        tools=TOOLS,
        messages=[{"role": "user", "content": case["input"]}],
    )
    used_tool = any(b.type == "tool_use" for b in resp.content)
    return {
        "tool_ok": used_tool == case["expects_tool"],
        "tokens": resp.usage.input_tokens + resp.usage.output_tokens,
    }

def evaluate(system: str, cases: list[dict]) -> dict:
    results = [run_case(system, c) for c in cases]
    n = len(results)
    return {
        "tool_accuracy": sum(r["tool_ok"] for r in results) / n,
        "avg_tokens": sum(r["tokens"] for r in results) / n,
    }

cases = [json.loads(line) for line in open("cases.jsonl")]
old_prompt = open("prompts/v1_legacy.txt").read()
new_prompt = open("prompts/v2_minimal.txt").read()

print("legacy :", evaluate(old_prompt, cases))
print("minimal:", evaluate(new_prompt, cases))
E o cases.jsonl precisa ter os dois lados do problema, não só o caso em que a tool deve ser chamada:
{"input": "Qual o limite de rate da API no plano Pro?", "expects_tool": true}
{"input": "Valeu, resolveu aqui!", "expects_tool": false}
{"input": "Me explica o que é um webhook em uma frase.", "expects_tool": false}
Esse exemplo mede só uma dimensão (chamou a tool quando devia?), de propósito. Em produção você vai querer um juiz de qualidade da resposta, mas comece pelo que é binário e barato. Overtriggering aparece exatamente aí: no caso do "valeu", o prompt legado tende a chamar a busca e o minimalista não.
Duas regras pra não se enganar:
- Inclua os casos de regressão. Se a regra em CAPS nasceu por causa de um incidente, esse incidente vira caso no dataset. É ele que prova se a regra ainda é necessária.
- Olhe custo junto com acerto. Empate em acerto com menos tokens e menos tool calls é vitória. A OpenAI usa a mesma lógica pro
effort: "Increase effort only when evals show a measurable quality gain".
Não vou te dar número de ganho, porque ele depende do seu harness, do seu modelo e do seu dataset. Quem promete "corte 50% do prompt e ganhe 20% de acurácia" sem mostrar o eval está vendendo outra coisa. O número que importa é o que o seu eval mostrar.
Limitações e pontos de atenção
Minimalismo não é ausência de guardrail. Permissão, sandbox, limite de custo, validação de saída e aprovação humana em ação destrutiva ficam. O modelo ser mais inteligente não muda o fato de que ele não deveria ter acesso de escrita no banco de produção sem checagem.
Não vale pra todo modelo ao mesmo tempo. Se você roteia entre um modelo grande e um pequeno, o pequeno pode ainda precisar da muleta que o grande dispensa. Prompt por modelo, eval por modelo.
A direção muda entre versões. A própria OpenAI já orientou, na época do GPT-5.1, reforçar persistência porque o modelo às vezes era conciso demais. Ou seja: o guia de hoje pede menos, mas a resposta certa é a que o eval mostra para o modelo que você está rodando, não a moda do momento.
Sem eval, não mexa. Se você não tem dataset nenhum, o primeiro passo não é apagar regra. É montar os 30 casos.
FAQ rápido
O que é harness minimalista? É manter no harness só o que o modelo atual realmente precisa: infraestrutura (tools, estado, guardrails, observabilidade) sim, muletas de modelo antigo (regras enfáticas, few-shot gigante, pipeline rígido) não. E reauditar isso a cada troca de modelo, com eval.
Como migrar prompt para um modelo novo sem quebrar o que funciona? Comece de um baseline enxuto, como recomenda a OpenAI, e adicione de volta só o que o eval provar necessário. Remova uma categoria por vez e mantenha os casos de incidente no dataset.
Menos tools sempre é melhor para o agente? Não sempre. Menos tools redundantes é melhor. A Anthropic recomenda poucas tools bem desenhadas e consolidadas pros fluxos de alto impacto, com descrição clara de quando usar cada uma (fonte).
Como criar um harness já pensando nisso? Separe desde o início o que é infraestrutura do que é instrução de comportamento. Versione o system prompt, anote o motivo de cada regra (qual incidente ela corrige) e mantenha o dataset de eval junto do código. O passo a passo de um primeiro harness está no tutorial de harness em Laravel do zero.
Conclusão
Harness não é monumento. É andaime. E harness minimalista é só o hábito de desmontar o andaime que o prédio já não usa.
Toda regra que você escreveu foi uma aposta sobre a limitação de um modelo específico. Quando o modelo muda, a aposta precisa ser reavaliada, e a Anthropic e a OpenAI estão dizendo, por escrito, que boa parte dessas apostas virou ruído.
O próximo passo dessa história é óbvio: harness que se audita sozinho. O Google já abriu código nessa direção com o Harness2. Até isso virar padrão, o trabalho é seu: abrir o system prompt, apagar o primeiro CRITICAL e rodar o eval.
{AI Engineer} — apaixonado por Laravel, arquitetura de software e construir produtos com impacto. Compartilho aqui tutoriais, descobertas e reflexões sobre o dia a dia de engenharia.
Conteúdo é o que não falta. Falta quem desembaralhe: o que importa agora é como implementar do jeito certo. No Clã você tem isso ao vivo, toda semana, com quem já filtrou o ruído.
Entrar no Clã