Como usar skills no Claude Code: criar o SKILL.md e quando ela vence MCP e CLAUDE.md
Seu CLAUDE.md tem 400 linhas e o Claude ignora metade.
Não é birra do modelo. É física de contexto: tudo que está no CLAUDE.md entra em toda sessão, em toda tarefa, competindo pela atenção com o que realmente importa naquele momento.
A skill resolve isso do jeito certo. O conhecimento só entra no contexto quando a tarefa pede.
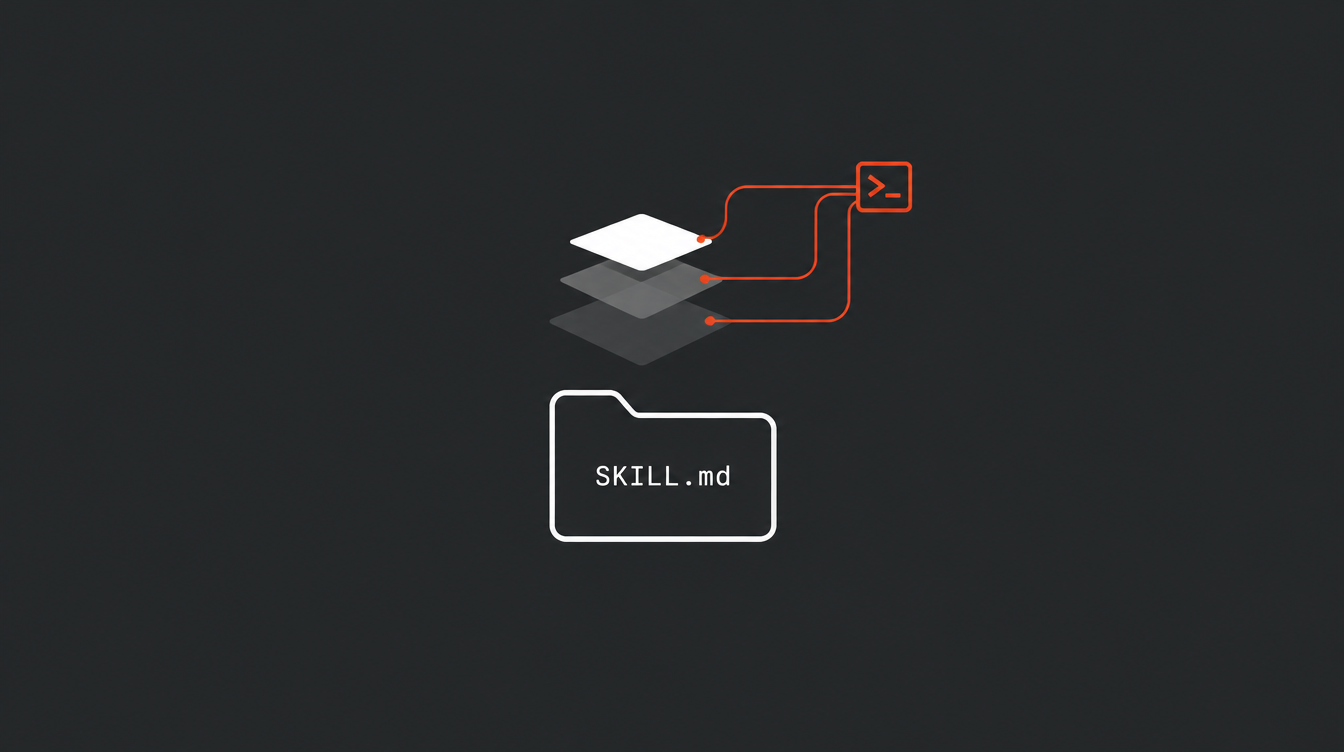
Usar skills no Claude Code é empacotar um processo numa pasta com um arquivo SKILL.md, que o agente só carrega quando a tarefa bate com a descrição dela. Neste tutorial você vai aprender como usar skills no Claude Code do jeito que funciona em produção: a estrutura da pasta, o frontmatter do SKILL.md, como o carregamento progressivo economiza contexto, como empacotar scripts e referências dentro da skill e como testar se o agente aciona. O exemplo vivo são as skills que rodam o pipeline editorial deste blog. Este post, inclusive, foi escrito, revisado e publicado por elas. E no fim tem a matriz de decisão que ninguém te entrega: quando usar skill, MCP, CLAUDE.md, slash command ou subagente.
TL;DR
- O que é: uma skill é uma pasta com um
SKILL.md(frontmatter YAML + instruções em Markdown) e, opcionalmente, scripts e arquivos de referência. O Claude Code só carrega adescriptionna largada; o resto entra quando a skill é acionada. - Onde mora:
.claude/skills/<nome>/SKILL.mdno projeto ou~/.claude/skills/<nome>/SKILL.mdpra todos os seus projetos. - Campos que importam:
nameedescription. Os extras do Claude Code (disable-model-invocation,allowed-tools,context: fork,arguments) entram quando você precisa de controle fino. - Custo/Acesso: recurso nativo do Claude Code, sem instalar nada. O formato segue o padrão aberto Agent Skills.
- Link útil: documentação oficial de skills do Claude Code.
O contexto: por que skill existe (e por que seu CLAUDE.md incha)
Todo setup de Claude Code passa pela mesma fase.
Você começa com um CLAUDE.md enxuto. Aí aparece o processo de deploy. Depois o checklist de code review. O passo a passo de criar migration. As regras do relatório mensal. Tudo vai pro mesmo arquivo, porque é o único lugar que o agente "sempre lê".
O problema é exatamente esse "sempre". Instrução de deploy não ajuda em nada quando a tarefa é corrigir um teste. Ela só ocupa espaço e dilui a atenção do modelo no que importa. Já falamos disso quando a Anthropic cortou 80% do system prompt do Claude Code: o que entra fixo no contexto tem que ser mínimo e certeiro.
A skill inverte a lógica. Segundo a doc oficial, numa sessão normal só as descrições das skills ficam carregadas, pra que o Claude saiba o que existe. O conteúdo completo só entra quando a skill é invocada. Arquivos de apoio, só quando são referenciados.
São três camadas:
- Sempre no contexto:
name+descriptionde cada skill. - Na invocação: o corpo do
SKILL.md, que entra na conversa como uma mensagem e fica lá pelos turnos seguintes. - Sob demanda: os arquivos de
references/que oSKILL.mdmanda ler, e osscripts/que ele manda executar (script roda, não é carregado).
No pipeline deste blog são oito skills, e somadas dão 1.265 linhas de SKILL.md. Se isso tudo morasse no CLAUDE.md, cada sessão começaria com um manual inteiro de processo editorial carregado, inclusive quando a tarefa é só corrigir um typo. Como skills, o custo fixo é uma linha de descrição por skill.
Esse é o tipo de decisão de arquitetura de contexto que a gente leva pra mesa no Clã Beer and Code: harness, agentes, RAG e evals montados junto com quem está colocando IA em produção, não só lendo sobre ela.
Se você quer o lado da notícia (o padrão Agent Skills foi doado pra Agentic AI Foundation em 22/10/2026), está tudo no post sobre o que muda pro seu SKILL.md com o padrão aberto. Aqui o foco é o como-fazer.
Pré-requisitos
- [ ] Claude Code instalado e rodando num projeto (se ainda não usa, comece por o que é o Claude Code e como funciona)
- [ ] Um processo que você repete e hoje explica no chat toda vez (deploy, review, release notes, relatório)
- [ ] Noção básica de YAML e Markdown
- [ ] Opcional: um script que já faz parte desse processo (bash, Python, PHP, tanto faz)
Mão na massa: como criar e usar skills no Claude Code
Passo 1: crie a pasta no lugar certo
O nome da pasta vira o nome do comando. O Claude Code procura skills em alguns escopos, segundo a doc:
| escopo | caminho | quem enxerga |
|---|---|---|
| Projeto | .claude/skills/<nome>/SKILL.md |
quem abre esse repo (commita e o time inteiro ganha) |
| Pessoal | ~/.claude/skills/<nome>/SKILL.md |
você, em todos os projetos |
| Aninhado | <subdir>/.claude/skills/<nome>/SKILL.md |
sessões que mexem em arquivos daquele subdiretório |
| Plugin | <plugin>/skills/<nome>/SKILL.md |
quem instala o plugin, como /plugin:nome |
Regra prática: processo do projeto vai em .claude/skills e entra no git. Preferência sua vai em ~/.claude/skills.
O pipeline deste blog é todo de projeto. A estrutura real é esta:
.claude/skills/
├── cacar-news-jacking/
│   ├── SKILL.md
│   ├── references/
│   │   ├── grok-prompt.md
│   │   ├── output-template.md
│   │   └── sources.md
│   ├── scripts/
│   │   └── detect.sh
│   └── state/
├── criar-post-blog/
│   ├── SKILL.md
│   ├── references/
│   │   ├── audio-script.md
│   │   ├── brand-voice.md
│   │   ├── post-template.md
│   │   └── sources.md
│   ├── scripts/
│   │   ├── generate-audio.sh
│   │   └── generate-cover.sh
│   └── voice/
└── minerar-evergreen/
    ├── SKILL.md
    └── references/
        └── output-template.md
Repare que só o SKILL.md é obrigatório. A minerar-evergreen tem uma referência e zero scripts. A cacar-news-jacking tem até uma pasta state/ pra guardar snapshot entre execuções. A pasta é sua: organize como o processo pede.
Passo 2: escreva o frontmatter (a parte que mais importa)
O SKILL.md começa com YAML entre ---. Detalhe que derruba gente: o Claude Code só lê o frontmatter se o --- de abertura estiver na primeira linha do arquivo. E se o YAML não parsear, a skill carrega com todos os campos vazios, sem erro na sua cara.
O frontmatter real da skill que caça pauta quente neste blog:
---
name: cacar-news-jacking
description: Caça temas de news-jacking para o blog Beer & Code (blog.beerandcode.com.br) — detecta notícias/lançamentos/dramas de IA em ascensão ANTES da SERP saturar e devolve candidatos de pauta ranqueados, já com títulos otimizados pra CTR. Cruza detecção em tempo real (Hacker News, OpenRouter, Polymarket, GitHub, Reddit, NewsAPI/GDELT, RSS dos labs + X/Twitter via Grok) com qualificação de SEO (DataForSEO + GSC). Acionar quando o usuário pedir "caçar tema", "o que tá quente", "tem notícia pra surfar", "achar tema de news-jacking", "tema quente de IA", "o que postar hoje" ou equivalente. Entrega candidatos ranqueados (não escreve nem publica — para isso use planejar-pauta e depois criar-post-blog).
---
Essa description tem três partes, e as três são de propósito:
- O que faz, na primeira frase.
- Quando acionar, com as frases que eu realmente digito ("o que tá quente", "o que postar hoje").
- O que não faz, apontando pra skill vizinha. Sem essa linha, o Claude tenta escrever o post dentro da skill de caça.
A description é o roteador. É a única coisa que o modelo vê antes de decidir se carrega a skill. Description vaga, skill que nunca dispara. Description genérica demais, skill que dispara em tudo.
Dois limites que a doc do Claude Code documenta: o texto combinado de description + when_to_use é truncado em 1.536 caracteres na listagem, e a listagem inteira de skills tem um orçamento de 1% da janela de contexto. Com muitas skills, o Claude Code começa a cortar descrições, começando pelas skills que você menos usa. Por isso: gatilho principal na frente, detalhe de processo no corpo.
Os campos que vale conhecer:
| campo | pra que serve |
|---|---|
name |
nome do comando no menu /. Default: nome da pasta |
description |
o que faz e quando usar. O campo que decide o acionamento |
when_to_use |
gatilhos extras, anexados à description na listagem |
disable-model-invocation: true |
só você aciona, via /nome. O Claude não carrega sozinho |
user-invocable: false |
some do menu /. Só o Claude aciona |
allowed-tools |
ferramentas liberadas sem prompt de permissão durante a skill |
arguments / argument-hint |
argumentos nomeados e dica de autocomplete |
context: fork + agent |
roda a skill num subagente isolado |
model, effort |
troca modelo ou esforço no turno da skill |
paths |
só ativa automaticamente quando o trabalho envolve arquivos que batem com o glob |
Dois cuidados. Campo com nome errado é ignorado em silêncio, então disable-model-invokation (com k) simplesmente não faz nada. E fora do Claude Code (upload no claude.ai, Skills API) só valem name, description, license, compatibility, metadata e allowed-tools; campo a mais dá erro duro. Se a skill vai viajar, fique no núcleo.
Passo 3: escreva o corpo como processo, não como prompt
Depois do frontmatter vem Markdown comum. O que funciona é tratar o corpo como runbook: inputs, passos numerados, critério de saída. A doc recomenda manter o SKILL.md abaixo de 500 linhas; a maior skill do pipeline daqui tem 244.
Um trecho real da minerar-evergreen. Repare que não é "seja criativo e ache bons temas". É regra de negócio com data e motivo:
## Gate de DOR (topo de funil) — aplicar antes de qualquer outro

O que funciona como evergreen neste blog é **dor de consciência baixa**:
quem busca ainda não escolheu produto, mas tem um problema concreto.
Pauta centrada em produto ("o que é o Codex", "como instalar o Claude Code")
foi rejeitada em 13/09/2026: é news-jacking disfarçado, morre quando a
ferramenta muda.

- **Semear com verbos de problema**, não com nome de ferramenta...
- **Filtro por candidato**: "isso é uma dor ou é um produto?"
Essa é a diferença entre skill boa e skill decorativa. Ela carrega decisões que o time já tomou, com o porquê. O modelo não precisa redescobrir que pauta de produto morre rápido. Alguém já pagou esse aprendizado.
Outra coisa que a doc avisa e vale ouro: depois de uma compactação de contexto, o Claude Code mantém só os primeiros 5.000 tokens de cada skill invocada (com orçamento combinado de 25.000). Então regra crítica vai no topo do SKILL.md, não no rodapé. As skills deste blog abrem com uma seção "Constantes do projeto (não perguntar)" exatamente por isso.
Passo 4: tire o peso do SKILL.md com references e scripts
Aqui está o carregamento progressivo trabalhando a seu favor.
A criar-post-blog precisa do guia de voz da marca (quase 8 KB), do template de post, das regras de roteiro de áudio. Nada disso está no SKILL.md. Ele só aponta:
### 3. Escrita

Antes de escrever, **leia `references/brand-voice.md`**. O tom é o
diferencial do blog — não é negociável.
O guia de voz só entra no contexto no passo de escrita. Na fase de pesquisa, não ocupa nada.
Com script é ainda melhor, porque o código roda e só a saída volta pro contexto. A cacar-news-jacking bate em Hacker News, OpenRouter, Polymarket, GitHub e GDELT num detect.sh de 9,5 KB. O SKILL.md só diz como chamar:
bash .claude/skills/cacar-news-jacking/scripts/detect.sh            # foco default
bash .claude/skills/cacar-news-jacking/scripts/detect.sh -q "claude OR anthropic"
Tudo que é determinístico (bater em API, montar JSON, converter áudio, subir arquivo pro storage) vai pra script. O modelo orquestra e interpreta. Não gaste token pedindo pro LLM fazer o trabalho do curl.
Uma confissão honesta: as skills daqui usam caminho relativo à raiz do repo, porque o Claude Code sempre roda de lá. Se a skill pode ser instalada em outro escopo, use a variável ${CLAUDE_SKILL_DIR}, que resolve pro diretório da skill seja ela de projeto, pessoal ou de plugin:
python3 ${CLAUDE_SKILL_DIR}/scripts/visualize.py .
Passo 5: argumentos e contexto dinâmico
Agora uma skill nova, do zero, pra fixar o resto. Release notes a partir do git, com argumento e contexto injetado:
---
name: release-notes
description: Gera release notes em pt-BR a partir dos commits desde a última tag. Use quando o usuário pedir "release notes", "changelog da versão" ou "o que mudou desde a última release".
argument-hint: "[versão]"
arguments: versao
allowed-tools:
  - Bash(git log *)
---

# Release notes da versão $versao

## Commits recentes (a tag aparece entre parênteses)

!`git log --oneline --no-merges --decorate -50`

## Instruções

1. Considere só os commits acima da última tag e agrupe em: Novidades, Correções, Interno.
2. Ignore commits de chore/ci, a menos que mudem comportamento visível.
3. Siga o formato de `references/formato.md`.
4. Termine com uma linha de "Breaking changes", mesmo que seja "nenhuma".
Três mecanismos nesse arquivo:
$versaovem do campoarguments./release-notes 2.4.0preenche o valor. Também existem$ARGUMENTS(tudo que foi digitado) e$0,$1posicionais.!`comando`roda antes do Claude ver a skill e cola a saída no lugar. O modelo já recebe os commits prontos, sem gastar uma tool call. Se o comando falhar, a invocação inteira aborta, e o comando passa pelas regras de permissão (por isso oallowed-tools).allowed-toolslibera só aqueles comandos sem prompt durante o turno da skill. A liberação acaba na sua próxima mensagem.
Passo 6: teste se o agente aciona
Skill que não dispara é arquivo morto. O roteiro de teste:
- Veja se carregou. Abra o menu
/skillsou pergunte "What skills are available?" na sessão. Se não aparecer, o problema é de arquivo, não de description. - Teste a invocação direta.
/release-notes 2.4.0. Se funcionar direto mas não automático, o problema é a description. - Teste o automático com a frase real. Peça do jeito que você pediria num dia normal: "o que mudou desde a última release?". Se não disparar, coloque essa frase literalmente na description.
- Teste o falso positivo. Peça algo vizinho ("resume o último commit") e veja se a skill dispara sem dever. Se disparar, a description está larga demais.
- Valide o YAML.
claude plugin validate .claude/skillsachaSKILL.mdcom frontmatter quebrado (Claude Code v2.1.233+).claude --debugmostra erro de parse.
Pra quem quer número em vez de impressão, o plugin skill-creator gera prompts que deveriam e que não deveriam acionar a skill, mede a taxa de acerto e sugere ajustes na description. É o mesmo raciocínio de eval que você aplicaria em qualquer feature de IA: sem medir, você está chutando.
Uma armadilha que eu aprendi na marra: a skill pode acionar certo e o Claude parar de seguir uma regra dela turnos depois. A criar-post-blog tem um aviso em negrito pra rodar o script de áudio de forma bloqueante, nunca em background, porque em sessão headless o agente encerrava o turno esperando o mp3 e o post nunca era publicado. A doc é direta sobre isso: regra que precisa valer toda vez não é trabalho de skill, é trabalho de hook, que roda sempre que o evento acontece, siga o modelo a skill ou não. Skill é orientação com julgamento. Hook é garantia.
Tutorial te mostra o caminho — no Clã você constrói junto. Aula ao vivo toda semana, projetos reais de Engenharia de IA, ao lado de quem já está em produção.
Entrar no ClãSkill vs MCP vs CLAUDE.md vs slash command vs subagente
Essa é a decisão que fica. Cinco peças, cinco problemas diferentes:
| peça | o que é | entra no contexto | use quando |
|---|---|---|---|
| CLAUDE.md | contexto fixo do projeto | sempre, em toda sessão | regra que vale pra qualquer tarefa: stack, convenções, comandos de teste, o que nunca fazer |
| Skill | conhecimento procedural empacotado | só a description; o resto sob demanda | processo de vários passos que só importa em certas tarefas |
| MCP | protocolo que conecta ferramentas e dados externos | definição das tools | o agente precisa agir num sistema: API, banco, CMS, SaaS |
| Slash command | atalho acionado por você | quando você digita | hoje é uma skill: .claude/commands/deploy.md e .claude/skills/deploy/SKILL.md criam o mesmo /deploy |
| Subagente | outro agente, com contexto próprio | só o resultado volta | tarefa isolável que suja o contexto ou cabe num modelo mais barato |
O pipeline deste blog usa as cinco, e cada uma no seu lugar:
- CLAUDE.md guarda a regra que vale sempre: nunca mexer em produção sem autorização explícita. Isso não pode depender de uma skill ser acionada.
- Skills guardam os processos: caçar pauta, minerar evergreen, escrever, revisar SEO.
- MCP é a mão do agente no CMS. A
criar-post-blogsabe como publicar; o MCPbeer-and-code-blogé o que publica (create-post,upload-image,upsert-post-translation). Skill ensina processo. MCP dá capacidade. Uma não substitui a outra, e a melhor skill costuma orquestrar várias tools MCP. Se você quer construir o lado do protocolo, tem o tutorial de servidor MCP do zero. - Slash command virou detalhe de interface. Toda skill do projeto já é um
/nome. Se você quer que só humano dispare (deploy, por exemplo), usedisable-model-invocation: truee pronto. - Subagente pega a parte que não precisa do modelo caro. A reescrita do post em roteiro de narração é transformação de texto pura, então a skill delega pro subagente
roteiro-narracao, que roda em Haiku:
---
name: roteiro-narracao
description: Reescreve o body em Markdown de um post do blog Beer & Code numa versão narrável (texto plano UTF-8) pronta para TTS. Use SEMPRE no passo 5.1 da skill `criar-post-blog`...
model: haiku
---
Repare que subagente também tem description: o mecanismo de roteamento é o mesmo. A diferença é que a skill injeta instrução no seu contexto, e o subagente roda num contexto separado e só devolve o resultado. E existe o meio-termo: context: fork faz a própria skill rodar como subagente.
A heurística curta:
- Vale pra toda tarefa? CLAUDE.md.
- Vale pra um tipo de tarefa e é processo? Skill.
- Precisa falar com sistema externo? MCP (chamado de dentro da skill, se tiver processo em volta).
- Só humano pode disparar? Skill com
disable-model-invocation: true. - Gera muito lixo de contexto ou cabe em modelo barato? Subagente.
- Tem que acontecer sempre, sem exceção? Hook.
Pra ver hooks e MCP lado a lado com mais detalhe de config, o post sobre a anatomia de um harness produtivo complementa este.
Limitações e pontos de atenção
- Acionamento é probabilístico. A description aumenta a chance, não garante. Processo crítico merece invocação explícita (
/nome) ou hook. - Skill invocada não é relida. O Claude Code injeta o conteúdo uma vez e não volta no arquivo nos turnos seguintes. Editou o
SKILL.mdno meio da sessão? Invoque de novo. Depois de compactação, idem. - Orçamento de descrições é compartilhado. Muita skill instalada, descrições cortadas, acionamento piorando sem você perceber.
/doctormostra o custo da listagem; skill que você não usa, desligue. - Skill com script é código executando com as suas permissões. Skill de terceiro se lê antes de instalar, igual a dependência. O vetor é o mesmo do repositório "limpo" que faz o Claude Code instalar malware.
allowed-toolsnão é sandbox. Ele libera prompt de permissão, não restringe o que mais pode rodar. Pra bloquear, use regras de deny nas permissões.- Segredo não mora na skill. Credencial vai no
.enve o script lê de lá. A pasta da skill vai pro git.
FAQ rápido
Qual a diferença entre skill e CLAUDE.md? O CLAUDE.md entra inteiro em toda sessão. A skill só ocupa a linha da description até ser acionada. Regra universal do projeto fica no CLAUDE.md; processo que só importa em certas tarefas vira skill. Se o seu CLAUDE.md tem seção "como fazer X", essa seção provavelmente é uma skill esperando pra nascer.
Skill substitui MCP? Não. MCP dá ao agente a capacidade de agir em sistemas externos: API, banco, CMS. A skill ensina o processo, e pode usar tools MCP no caminho. No pipeline deste blog, a skill de criar post sabe a ordem dos passos; o MCP do blog é quem cria o post de fato. Pra entender o protocolo, veja o que é MCP.
Meus slash commands em .claude/commands/ param de funcionar?
Não. A doc oficial diz que custom commands foram fundidos nas skills e os arquivos em .claude/commands/ continuam funcionando. Se houver skill e command com o mesmo nome, a skill vence. Pra coisa nova, prefira skill, porque ela suporta arquivos de apoio na pasta.
Por que minha skill não dispara?
Na ordem: confira se ela aparece no /skills; teste /nome direto; se direto funciona, reescreva a description com as palavras que você usa ao pedir. YAML quebrado também mata o acionamento automático sem erro visível; claude plugin validate .claude/skills acha. Detalhes no troubleshooting oficial.
Conclusão
Skill não é prompt salvo. É conhecimento procedural com carregamento sob demanda: a description roteia, o SKILL.md instrui, references e scripts carregam o peso só quando a tarefa pede.
O jeito de começar é olhar pro seu CLAUDE.md e caçar as seções do tipo "quando for fazer X, siga estes passos". Cada uma é uma skill. Mova, escreva uma description com as frases que você realmente digita, teste o acionamento e veja o CLAUDE.md voltar a caber na cabeça do modelo.
O próximo passo natural é combinar skill com o resto do harness. Se o seu agente ainda trava em tarefa longa, o problema provavelmente está em outra peça: o post sobre harness engineering mostra onde olhar.
{AI Engineer} — apaixonado por Laravel, arquitetura de software e construir produtos com impacto. Compartilho aqui tutoriais, descobertas e reflexões sobre o dia a dia de engenharia.
Conteúdo é o que não falta. Falta quem desembaralhe: o que importa agora é como implementar do jeito certo. No Clã você tem isso ao vivo, toda semana, com quem já filtrou o ruído.
Entrar no Clã