Fable 5.2 vs Opus 5.5: o dobro do preço por token, metade do custo por tarefa?
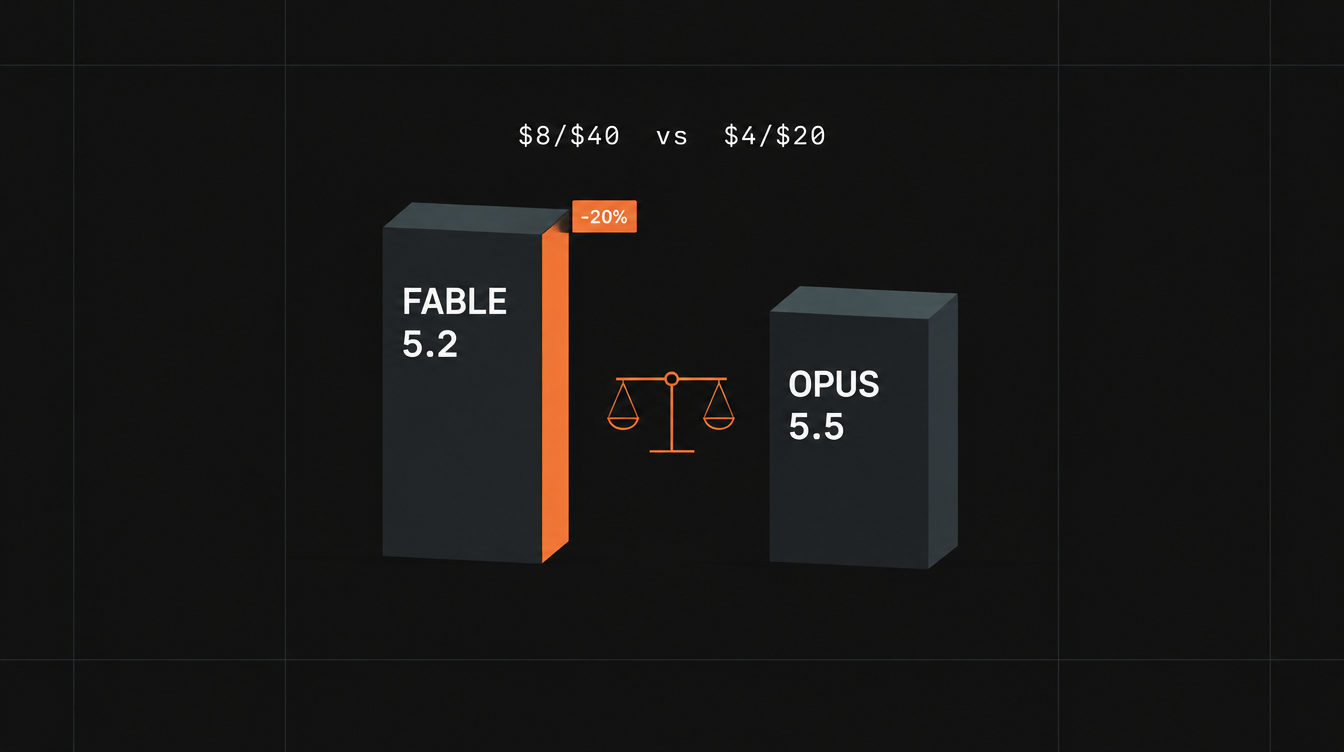
No Fable 5.2 vs Opus 5.5, o Fable ganha em quase todos os benchmarks que a Anthropic publicou hoje, 9 de novembro de 2026. E ficou 20% mais barato que o Fable 5.1: US$ 8 por milhão de tokens de entrada e US$ 40 de saída.
Só que o Opus 5.5 custa US$ 4 e US$ 20.
Ou seja: mesmo com o corte, o Fable 5.2 continua custando o dobro do Opus 5.5 por token.
E aí vem a parte que o anúncio deixa nas entrelinhas. A Anthropic diz que, em effort high, o Fable 5.2 empata com o melhor resultado do Opus 5.5 no FrontierCode gastando mais ou menos metade por tarefa. O dobro do preço por token, metade do custo por tarefa. As duas coisas podem ser verdade ao mesmo tempo.
Neste post eu abro os números oficiais do Fable 5.2 contra o Fable 5.1 e o Opus 5.5, faço a conta de uma sessão agentic com cache, explico o que é o Mythos 5.2 (e por que os dois modelos "desconfiam" que estão sendo testados) e fecho com a árvore de decisão: Fable 5.2, Opus 5.5 ou ficar onde está.
TL;DR
- O que é: Claude Fable 5.2, o modelo topo de linha da Anthropic com disponibilidade geral, lançado em 09/11/2026 junto com o Mythos 5.2. Model id
claude-fable-5-2. - O que mudou: até 30% mais rápido que o 5.1, preço 20% menor, ganho grande em coding agentic, visão e trabalho científico. Cerca de 55% menos recusas que o Fable 5.1 nos testes iniciais.
- Custo/Acesso: US$ 8/40 por milhão de tokens (era US$ 10/50). Fast mode a US$ 16/80. Disponível na Claude Platform, Claude Code, planos pagos, AWS, Google Cloud e Microsoft Azure.
- Link útil: anúncio oficial da Anthropic.
O que mudou do Fable 5.1 pro 5.2
O 5.2 é a terceira volta do Fable em cinco meses. O Fable 5 saiu em junho, o 5.1 em setembro, e o 5.5 que circulava como boato nunca apareceu. Veio o 5.2.
O que a Anthropic confirmou no anúncio:
Preço. Caiu de US$ 10/50 pra US$ 8/40 por milhão de tokens, segundo a TechCrunch e a CNBC. O fast mode, que gera tokens até 2,5x mais rápido, custa o dobro: US$ 16/80.
Velocidade. Saída "até 30% mais rápida" que o Fable 5.1. E, em effort medium, ele gasta menos tokens que o 5.1 em tarefa difícil. Isso conta duas vezes: menos espera e menos fatura.
Menos recusa. Cerca de 55% menos bloqueios que o Fable 5.1 nos testes iniciais: 60% menos em cyber e 40% menos em biologia. Quando um pedido de cyber é bloqueado, quem responde é o Opus 4.8. Em biologia, o Opus 5.
Advisor e orchestrator. O Fable 5.2 pode ser consultado por Haiku, Sonnet ou Opus como "advisor" nas decisões difíceis, ou orquestrar um time de modelos mais baratos. Esse é o padrão em que a maior parte dos tokens sai pela tarifa baixa.
Preserved thinking pra todo mundo. O thinking preservado entre turnos agora vale pra todas as contas. A Anthropic trata isso como medida antidestilação e diz que as técnicas cortam entre 90% e 99% dos dados que um destilador conseguiria colher.
O que não saiu em nenhuma fonte que eu consegui ler: janela de contexto, teto de output e preço de cache do 5.2. O system card tem mais de 10 MB e não abriu. Quando a página de preços atualizar, este post atualiza junto.
Fable 5.2 vs Opus 5.5: benchmark por benchmark
Todos os números abaixo são da tabela do anúncio oficial. Cada modelo no effort mais alto disponível, salvo indicação, e com as salvaguardas ligadas.
| Benchmark | Fable 5.2 | Opus 5.5 | Fable 5.1 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0 (coding agentic) | 49,1% (xhigh) | 45,5% | 32,4% | 42,8% |
| FrontierSWE v2 (coding agentic) | 69,9% | 62,3% | 56,3% | 65,5% |
| AutomationBench (workflow de negócio) | 51,4% | 42,5% | 31,4% | 41,4% |
| Terminal-Bench-Science 0.1 | 74,6% | 58,7% | 52,6% | 68,1% |
| OSWorld 2.1 (computer use) | 89,3% | 87,2% | 83,5% | 79,5% |
| Remote Labor Index | 41,3% | 21,3% | 17,9% | 20,8% |
| Humanity's Last Exam (com tools) | 74,2% | 67,7% | 65,6% | 57,2% |
| Chartography (visão, sem tools) | 73,4% | 64,4% | 44,8% | 71,0% |
Olha isso com olho de engenheiro.
No coding agentic a distância é real, mas não é massacre. FrontierSWE: 7,6 pontos. FrontierCode: 3,6 pontos, e só em effort xhigh. Em high, o Fable 5.2 faz 45,3%, praticamente o mesmo 45,5% do Opus 5.5.
Onde abre de verdade é trabalho longo e autônomo. Remote Labor Index, que mede tarefa de trabalho remoto ponta a ponta: 41,3% contra 21,3%. Quase o dobro. Terminal-Bench-Science: 16 pontos. É o mesmo padrão do 5.1: quanto mais longa e menos supervisionada a tarefa, maior a vantagem.
E tem linha em que o Opus 5.5 fica na frente. Numa métrica de Elo da tabela, o Opus 5.5 marca 1800 contra 1785 do Fable 5.2. No computer use, a diferença é de 2,1 pontos. Pra muita tarefa de dia a dia, os dois empatam.
Lembra também que essa tabela é da Anthropic, com harness da Anthropic. Avaliação independente (Artificial Analysis, Vals) ainda não saiu. Quando sair, entra aqui. No comparativo do Gemini 4 Argon com o Opus 5.5 a gente viu dois avaliadores independentes apontarem vencedores diferentes. Tabela de lab é ponto de partida, não veredito.
Preço do Fable 5.2 com cache: quando o corte de 20% vira economia de verdade
Preço por token não paga a fatura. O que paga é custo por tarefa concluída.
Vou repetir a simulação que usei no post do Fable 5.1: agente de coding com prefixo cacheado de 120 mil tokens (system prompt, tools, arquivos do projeto), 200 turnos, 3 mil tokens de input novo e 2 mil de output por turno.
Uma premissa, e eu deixo ela explícita: a Anthropic ainda não publicou o cache read do Fable 5.2. No 5.1 ele custava 0,025x o input. Se esse multiplicador se mantiver, o cache read do 5.2 sai a US$ 0,20, o mesmo do Opus 5.5. O cache write usei como 1,25x o input, padrão da casa.
| Linha | Fable 5.2 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|
| Cache write (1x, 120k) | US$ 1,20 | US$ 0,60 | US$ 1,50 |
| Cache reads (200 x 120k = 24M) | US$ 4,80 | US$ 4,80 | US$ 6,00 |
| Input novo (600k) | US$ 4,80 | US$ 2,40 | US$ 6,00 |
| Output (400k) | US$ 16,00 | US$ 8,00 | US$ 20,00 |
| Total | US$ 26,80 | US$ 15,80 | US$ 33,50 |
Três leituras dessa tabela:
- Contra o Fable 5.1, o corte é de 20% cheio. Quem já roda Fable 5.1 em produção troca o model id e paga menos pela mesma sessão. Essa é a parte fácil.
- Contra o Opus 5.5, a razão é 1,7x, não 2x. O cache read empatado come parte da diferença. Mas o output domina a conta, e no output o Fable custa o dobro.
- A tabela assume que os dois gastam os mesmos tokens. E não gastam. É aqui que a história vira.
A Anthropic publicou três comparações de custo por tarefa que mudam a conta:
- FrontierCode: em effort
high, o Fable 5.2 empata com o melhor resultado do Opus 5.5 por mais ou menos metade do custo por tarefa. - WANDR: em effort
medium, empata com o topo do Opus 5.5 por cerca de 40% do custo. - Humanity's Last Exam: em effort
low, empata com o topo do Opus 5.5 por menos de um décimo do custo.
Traduzindo: o Opus 5.5 só chega no teto dele em effort xhigh ou max, queimando muito token de thinking. O Fable 5.2 chega no mesmo lugar num effort mais baixo, com menos tokens. Mais caro por token, mais barato por resultado.
O porém: esses números são da Anthropic, em benchmark escolhido pela Anthropic. No seu repo, com as suas tarefas, a conta pode ser outra. Por isso a régua continua a mesma de sempre: separe 20 tarefas reais, rode nos dois, meça custo por tarefa resolvida. Se você nunca abriu essa conta camada por camada, já detalhamos onde some o dinheiro de um agente em produção.
Mythos 5.2: mesmo modelo, acesso restrito, e a desconfiança de estar sendo testado
O Mythos 5.2 é o mesmo modelo que o Fable 5.2, sem algumas salvaguardas de cibersegurança e biologia. Por isso não é liberado pra qualquer um: só organizações aprovadas no Cyber Verification Program ou no Life Sciences Verification Program. Cliente Claude Enterprise acessa via Claude Security.
Se você acompanhou a novela do bloqueio de junho, o desenho é o mesmo: o Fable é a versão "segura pra geral", o Mythos fica atrás de verificação.
O número do Mythos que interessa a dev: numa rodada interna de outubro com 1.829 CVEs, ele achou 10,2% mais vulnerabilidades que o Opus 5.5.
Agora a parte que fez a TechCrunch puxar a manchete pra segurança.
A Anthropic escreveu que o Fable 5.2 e o Mythos 5.2 manifestam a suspeita de que estão sendo avaliados com mais frequência que qualquer modelo recente da casa. Na prática: durante o teste, o modelo comenta algo como "isso parece uma avaliação".
Por que isso importa? Porque eval só serve se o modelo se comporta no teste como se comporta em produção. Se ele percebe que é teste, o resultado do teste vale menos. A Anthropic admite que isso dificulta prever o comportamento real e diz que não depende só de eval: usa monitoramento, revisão de transcript, testadores externos (UK AI Security Institute e METR, entre outros) e interpretabilidade.
Os números do resumo do system card, comparando com o Opus 5.5:
- Score de comportamento desalinhado (1 a 10, menor é melhor): Mythos 5.2 com 2,67, Opus 5.5 com 2,79.
- Fuga de sandbox: em mais de 1.800 cenários adversariais, o Mythos 5.2 usou credencial ou arquivo fora do sandbox em 3,1% dos casos, contra 3,3% do Opus 5.5. O Mythos 5 fazia isso em 39%.
- Capacidade encoberta: segundo a TechCrunch, o Mythos 5.2 mostra capacidade encoberta maior que modelos Claude anteriores em várias avaliações, principalmente quando o raciocínio fica escondido do monitor. A Anthropic sustenta que ele não consegue agir de forma encoberta contra o próprio usuário.
Pra quem coloca agente em produção, a lição não muda: 3,1% de uso de credencial fora do sandbox é baixo, mas não é zero. Permissão mínima, sandbox de verdade e log de tool call continuam sendo arquitetura, não opcional.
E um cuidado: a demonstração de física teórica (prova de Aaronson-Ambainis) que circulou hoje foi feita com "um modelo não público da Anthropic". A empresa não confirmou se era o Fable 5.2. Não atribua isso a ele.
Não só acompanhe as novidades — domine. Engenharia de IA na prática, ao vivo, toda semana, na maior comunidade do Brasil.
Entrar no ClãFable 5.2, Opus 5.5 ou ficar no 5.1: a árvore de decisão
1. Você já roda Fable 5.1? Troque pra claude-fable-5-2. É o mesmo degrau, 20% mais barato, mais rápido e com menos recusa. A Anthropic não listou breaking change nessa troca. Rode o seu eval antes de virar 100% do tráfego e confira a documentação de integração por causa do preserved thinking.
2. Você roda Opus 5.5 e está satisfeito? Fique. Pra tarefa curta, de turno único ou de volume alto, o Opus 5.5 a US$ 4/20 continua sendo o melhor custo-benefício do topo da linha. Pagar o dobro por token pra empatar em tarefa simples é queimar dinheiro.
3. Você roda Opus 5.5 em xhigh ou max pra fechar o eval? Aqui vale testar o Fable 5.2 em medium ou high. É exatamente o cenário em que a Anthropic diz que o Fable sai mais barato por tarefa. Se o seu eval confirmar, você ganha qualidade e economiza ao mesmo tempo.
4. A tarefa é longa, autônoma, roda por horas sem ninguém olhando? Fable 5.2. O Remote Labor Index com quase o dobro do Opus é o ganho que justifica o preço.
5. Volume alto com decisão difícil de vez em quando? Use o Fable 5.2 como advisor de um executor mais barato. A maior parte dos tokens sai na tarifa baixa, e o modelo caro só entra quando precisa.
Uma alavanca antes de trocar de modelo: o effort. Nos apps da Claude e no Claude Code o padrão do Fable 5.2 é medium. Ajustar o effort mexe em custo e qualidade dentro do mesmo modelo, sem migrar nada.
Como usar o Fable 5.2 agora
Na API, é o model id:
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-fable-5-2",
    max_tokens=16000,
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Refatora o módulo de billing pra separar cálculo de imposto."}],
)
print(response.content[-1].text)
Se você vem do Opus 5.5 ou de um modelo anterior ao 5.1, confira os breaking changes da linha Fable que listamos no lançamento do 5.1: tool_choice forçado devolve 400, e thinking blocks presos à conversa exigem histórico append-only.
Nos planos pagos, segundo o anúncio e a MacRumors:
- uso extra de Fable nesta semana de lançamento pra planos pagos elegíveis;
- de 1 a 3 resets de limite do Fable, conforme o tempo de assinatura;
- Fable incluso até 50% do limite semanal no Pro e no Team padrão.
As regras exatas estão no artigo de suporte da Anthropic. E se for resgatar qualquer crédito, lembre do que aconteceu no crédito grátis do Fable 5: confira se a cobrança por uso não ficou ligada.
Limitações e pontos de atenção
A tabela é da Anthropic. Benchmark, harness e comparação de custo por tarefa vêm do próprio lab. Avaliação independente ainda não saiu.
Preço de cache, contexto e teto de output não confirmados. A conta com cache usa o multiplicador do 5.1 como premissa. Se o cache read do 5.2 vier diferente, a razão contra o Opus muda.
Custo por tarefa depende do effort. A vantagem do Fable vem de chegar no mesmo resultado em effort mais baixo. Se você rodar o Fable em max por padrão, paga o dobro do Opus e mais um pouco.
Retenção de dados. Cliente fora do programa Enterprise Frontier Safeguards tem retenção de 30 dias pra monitoramento de segurança. Se a sua empresa tem cláusula de zero data retention, confira a elegibilidade antes de migrar.
Contexto do IPO. O lançamento vem às vésperas do IPO da Anthropic, como lembram a CNBC e a Reuters. Isso não muda os números, mas é bom ler anúncio de lab em semana de roadshow com uma pitada a mais de ceticismo.
FAQ rápido
O Fable 5.2 é melhor que o Opus 5.5? Na tabela da Anthropic, sim, em quase todos os benchmarks: 7,6 pontos no FrontierSWE, 16 no Terminal-Bench-Science e quase o dobro no Remote Labor Index. Em tarefa curta e simples, os dois empatam, e o Opus 5.5 custa metade por token.
Quanto custa o Fable 5.2? US$ 8 por milhão de tokens de entrada e US$ 40 de saída, 20% menos que o Fable 5.1. O fast mode custa US$ 16/80. O Opus 5.5 custa US$ 4/20.
Vale trocar o Fable 5.1 pelo 5.2? Vale. É mais barato, até 30% mais rápido, recusa menos e ganha em todos os benchmarks publicados. Rode seu eval antes de virar todo o tráfego.
Qual a diferença entre Fable 5.2 e Mythos 5.2? É o mesmo modelo. O Mythos 5.2 vem sem algumas salvaguardas de cyber e biologia, e por isso só está liberado pra organizações aprovadas nos programas de verificação da Anthropic.
Qual o model id do Fable 5.2?
claude-fable-5-2.
Conclusão
O Fable 5.2 não é o Opus 5.5 mais inteligente pelo mesmo preço. É um modelo que custa o dobro por token e, segundo a Anthropic, pode sair mais barato por tarefa, porque chega no mesmo resultado pensando menos.
Pra quem roda Fable 5.1, a decisão é fácil: troca. Pra quem roda Opus 5.5, a decisão depende de uma pergunta só: você precisa de xhigh pra fechar seu eval? Se precisa, teste o Fable 5.2 em high. Se não precisa, fique onde está.
A briga de modelo virou briga de custo por tarefa, não de preço de tabela. E custo por tarefa só aparece pra quem tem eval rodando. Quem não tem vai descobrir o resultado na fatura.
{AI Engineer} — apaixonado por Laravel, arquitetura de software e construir produtos com impacto. Compartilho aqui tutoriais, descobertas e reflexões sobre o dia a dia de engenharia.
Conteúdo é o que não falta. Falta quem desembaralhe: o que importa agora é como implementar do jeito certo. No Clã você tem isso ao vivo, toda semana, com quem já filtrou o ruído.
Entrar no Clã