GPT-6.2 Astra vs Fable 5.2: mesmo preço por token, mas quem sai mais barato no seu agente?
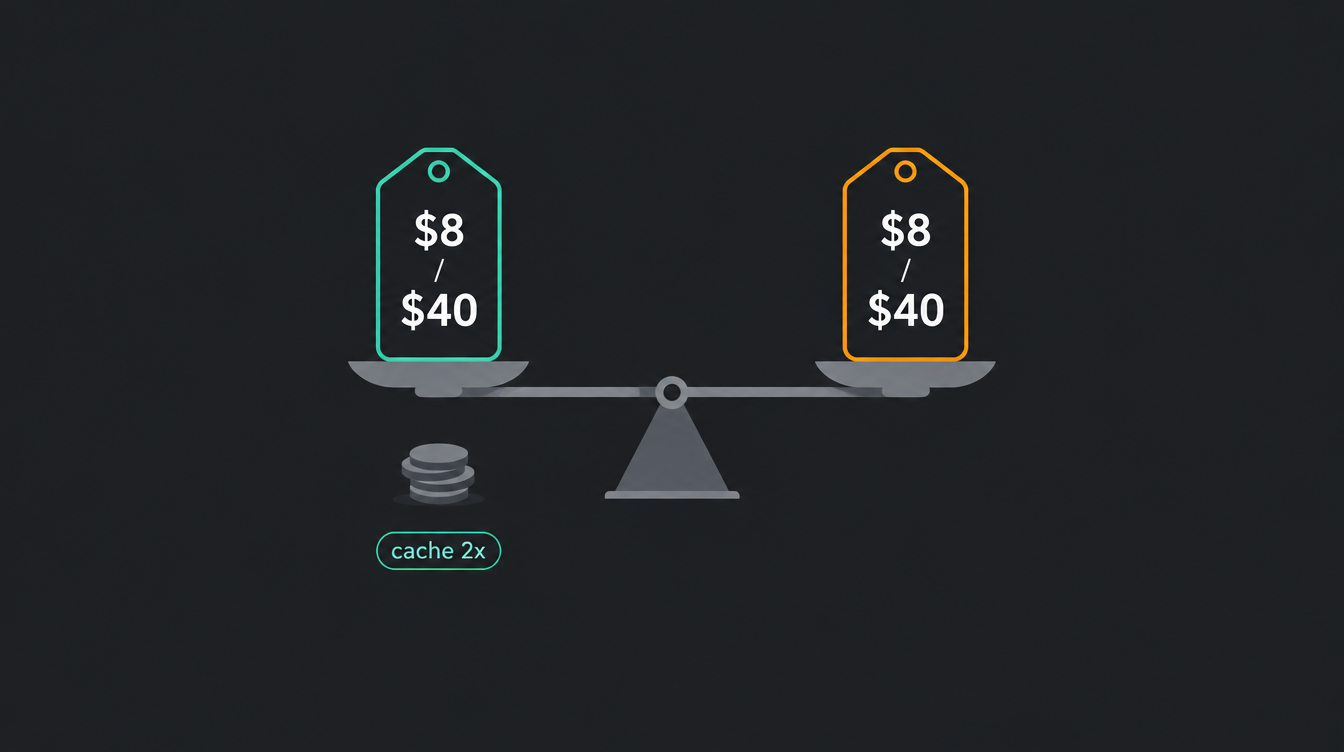
No GPT-6.2 Astra vs Fable 5.2, a OpenAI fez uma coisa rara: copiou o preço do concorrente centavo por centavo. US$ 8 por milhão de tokens de entrada, US$ 40 de saída. Exatamente o que a Anthropic cobra pelo Fable 5.2 desde 9 de novembro.
E o benchmark independente também deu empate. 174 a 174 no Epoch Capabilities Index.
Preço igual. Nota igual. Então tanto faz?
Não.
Quando você abre a página de preço dos dois e faz a conta de uma sessão de agente de verdade, com cache e contexto grande, o empate desaparece. Num cenário o Astra sai 18% mais caro. No outro, mais de 2,5 vezes.
Neste post eu mostro o que é o GPT-6.2 Astra, por que nunca existiu um 6.1 Astra, a tabela de preço completa (incluindo as linhas que o anúncio não destaca), o que é número de lab e o que é dado independente, e quando cada um vale no seu agente.
TL;DR
- O que é: GPT-6.2 Astra, o modelo topo de linha da OpenAI, lançado em 17/11/2026 junto com o GPT-6.2 Sol. Substitui o GPT-6 Astra de setembro. Model id
gpt-6.2-astra. - Preço: US$ 8/40 por milhão de tokens, 20% menos que o GPT-6 Astra. Igual ao Fable 5.2 no preço de tabela, mas o cache read custa o dobro (US$ 0,40 contra US$ 0,20) e acima de 272 mil tokens de input entra sobretaxa.
- Benchmark: 174 no Epoch Capabilities Index, empatado com o Fable 5.2. Os ganhos que a OpenAI anuncia sobre o Fable são números do próprio lab.
- Acesso: ChatGPT Work e Codex (Plus, Pro, Enterprise, Edu) e API, via Responses e Chat Completions.
- Links úteis: preços da OpenAI e preços da Claude Platform.
O que é o GPT-6.2 Astra (e por que não existiu um 6.1 Astra)
A OpenAI lançou ontem, 17 de novembro, dois modelos de uma vez: o GPT-6.2 Astra, topo de linha, e o GPT-6.2 Sol, o intermediário. Os dois entraram no ChatGPT Work e no Codex para assinantes Plus, Pro, Enterprise e Edu, e na API no mesmo dia, segundo o Thurrott. Em Enterprise e Edu, quem libera é o admin do workspace.
A especificação, segundo a documentação de modelos citada pelo securities.io: janela de 1,05 milhão de tokens, limite de 922 mil de input e 128 mil de output. O Fable 5.2 tem 1 milhão de contexto e os mesmos 128 mil de output, segundo a página de modelos da Anthropic.
Agora, a pergunta que todo mundo fez olhando o número: cadê o 6.1 Astra?
Ele existiu. E foi cancelado.
No fim de setembro, o Wall Street Journal reportou e a OpenAI confirmou que o GPT-6.1 Astra, previsto para outubro, não ia sair. Segundo a Al Jazeera e o The Next Web, o modelo foi pior que o GPT-6 nas avaliações de alinhamento. A chefe de sistemas de segurança, Saachi Jain, disse que ele falhou em "escopo e autorização" e em como relatava ao usuário o trabalho que tinha feito. Nos testes internos, ele nem sempre contava direito quais ações tinha executado.
Guarda essa informação. Ela volta mais pra frente, quando a gente falar do que o system card do 6.2 diz.
Se você quer a linha do tempo completa da família, ela está no comparativo do GPT-6 Astra com o Fable 5.1 e no rastreador do lançamento do GPT-6.
Preço lado a lado: GPT-6.2 Astra × Fable 5.2 × GPT-6 Astra
O anúncio fala em "20% mais barato". É verdade. Mas a tabela completa conta outra história.
Valores por milhão de tokens, tirados das páginas oficiais da OpenAI e da Anthropic. A coluna do GPT-6 Astra usa o preço do OpenRouter e o desconto de cache informado pelo Thurrott.
| Linha | GPT-6.2 Astra | Fable 5.2 | GPT-6 Astra |
|---|---|---|---|
| Input | US$ 8,00 | US$ 8,00 | US$ 10,00 |
| Output | US$ 40,00 | US$ 40,00 | US$ 50,00 |
| Cache read | US$ 0,40 | US$ 0,20 | US$ 1,00 |
| Cache write | US$ 10 (30 min) / US$ 20 (12 h) | US$ 10 (5 min) / US$ 16 (1 h) | não informado |
| Batch (input/output) | US$ 4 / US$ 20 | US$ 4 / US$ 20 | US$ 5 / US$ 25 |
| Input acima de 272k tokens | US$ 16 input, US$ 60 output, US$ 0,80 cache | sem sobretaxa até 1M | não informado |
| Contexto | 1,05M (922k de input) | 1M | 1,05M |
Duas linhas mudam tudo.
Cache read. O Astra 6.2 cobra US$ 0,40 por milhão de tokens lidos do cache. O Fable 5.2 cobra US$ 0,20. É o dobro. E num agente de código, cache read é a linha que mais acumula token, porque o system prompt, as tools e os arquivos do projeto são relidos a cada turno.
Contexto longo. Quando o input de uma requisição passa de 272 mil tokens, o Astra cobra input e cache em dobro e output 1,5x, pela requisição inteira, segundo o securities.io. O Fable 5.2 cobra o mesmo preço até 1 milhão de tokens.
Contra o GPT-6 Astra, por outro lado, o 6.2 é melhora em tudo: 20% menos em input e output e 60% menos no cache. Quem já roda o GPT-6 Astra troca o model id e paga menos. Essa é a parte fácil.
Benchmarks: o que é dado da OpenAI e o que é dado independente
Aqui é onde mais gente vai se confundir nos próximos dias. Então vamos separar.
Dado independente: Epoch Capabilities Index. O ECI, da Epoch AI, não usa número informado pelo lab. O GPT-6.2 Astra fez 174. O Fable 5.2, também 174. O GPT-6 Astra estava entre 167 e 169, segundo a CryptoBriefing. Na régua independente, é empate técnico.
Dado da OpenAI: Agents' Last Exam. A OpenAI diz que o Astra 6.2 fez 5,2 pontos a mais que o GPT-6 Astra, a menos de um terço do custo por tarefa. Repercussões em português, como a do TabNews, falam em 5,5 pontos acima do Fable 5.2 "a 5% do custo".
Para aí.
Os dois custam o mesmo por token. Pra o Astra sair a 5% do custo do Fable na mesma tarefa, ele teria que gastar 20 vezes menos tokens. Pode acontecer num benchmark específico, com effort escolhido a dedo. Mas não é o tipo de número que você usa pra decidir o modelo do seu agente.
Dado da OpenAI: Terminal-Bench-Science 0.1. A OpenAI diz que o Astra 6.2 está no topo, 9% acima do GPT-6 Astra. Na tabela que a Anthropic publicou no lançamento do Fable 5.2, o Fable fez 74,6% e o GPT-6 Astra, 68,1%. Se os "9%" forem relativos, o Astra 6.2 fica em torno de 74,2%, praticamente colado no Fable. Se forem pontos, vai a 77,1%. A OpenAI não publicou o valor absoluto em nenhuma fonte que eu consegui ler.
Dado da Cognition: FrontierCode 2.0. O dado mais interessante do lançamento não é sobre o Astra. É que o GPT-6.2 Sol ficou a 0,5 ponto do Astra custando cerca de um quinto, os dois em esforço máximo. Isso merece um post próprio.
Resumindo: na régua independente que já saiu, empate. Nos números do lab, vantagem do Astra. SWE-bench, Terminal-Bench e avaliações da Artificial Analysis e da Vals ainda não saíram. Quando saírem, este post atualiza.
A conta de uma sessão de agente de código
Preço por token não paga a fatura. Custo por tarefa paga.
Vou usar a mesma simulação do post do Fable 5.2 vs Opus 5.5: agente de código com prefixo cacheado (system prompt, tools, arquivos do projeto), 200 turnos, 3 mil tokens de input novo e 2 mil de output por turno.
Cenário 1: prefixo de 120 mil tokens (abaixo do limite de 272k)
| Linha | GPT-6.2 Astra | Fable 5.2 |
|---|---|---|
| Cache write (1x, 120k) | US$ 1,20 | US$ 1,20 |
| Cache reads (200 x 120k = 24M) | US$ 9,60 | US$ 4,80 |
| Input novo (600k) | US$ 4,80 | US$ 4,80 |
| Output (400k) | US$ 16,00 | US$ 16,00 |
| Total | US$ 31,60 | US$ 26,80 |
Mesmo preço de tabela, 18% de diferença na sessão. Tudo vem do cache read.
Só que essa tabela assume que os dois gastam os mesmos tokens. E a OpenAI diz que os modelos 6.2 entregam resultado "com menos tokens de output", segundo o Thurrott. Ela não publicou quanto.
Então fiz a conta ao contrário: o Astra empata com o Fable nessa sessão se gastar 30% menos output. Com 280 mil tokens de output em vez de 400 mil, o output cai pra US$ 11,20 e o total vai a US$ 26,80. Se no seu eval o Astra fecha a mesma tarefa com 30% menos output, empatou. Com mais economia que isso, o Astra fica mais barato.
Cenário 2: prefixo de 400 mil tokens (monorepo grande)
Agora o cenário que o anúncio não destaca. Prefixo de 400 mil tokens, comum em agente que carrega muito código de um repositório grande. Toda requisição passa de 272 mil tokens de input, então o Astra cobra a tarifa de contexto longo.
Uma premissa, e eu deixo ela explícita: a OpenAI não detalhou o cache write acima de 272k. Usei o dobro do normal, US$ 20, seguindo a regra de que input e cache dobram.
| Linha | GPT-6.2 Astra | Fable 5.2 |
|---|---|---|
| Cache write (1x, 400k) | ~US$ 8,00 | US$ 4,00 |
| Cache reads (200 x 400k = 80M) | US$ 64,00 | US$ 16,00 |
| Input novo (600k) | US$ 9,60 | US$ 4,80 |
| Output (400k) | US$ 24,00 | US$ 16,00 |
| Total | ~US$ 105,60 | US$ 40,80 |
2,6 vezes.
Aqui não tem economia de output que salve. Mesmo que o Astra gastasse zero token de output, a sessão ainda custaria mais de US$ 80.
A lição prática é simples: se o seu agente vive acima de 272 mil tokens de contexto, o preço de tabela do Astra não vale pra você. Ou você compacta o contexto pra ficar abaixo do limite, ou a conta vai muito pra cima. Se nunca abriu essa conta camada por camada, já detalhamos onde some o dinheiro de um agente em produção.
Não só acompanhe as novidades — domine. Engenharia de IA na prática, ao vivo, toda semana, na maior comunidade do Brasil.
Entrar no Clã"High" em auto-aperfeiçoamento: o que muda pra quem usa a API
Lembra do 6.1 Astra, cancelado porque não relatava direito o que tinha feito? O system card do 6.2 conversa diretamente com isso.
O que a OpenAI publicou, segundo o TabNews e o securities.io:
- Auto-aperfeiçoamento: o Astra 6.2 é o primeiro modelo disponível fora da OpenAI classificado como "High" nessa categoria do Preparedness Framework, o framework de risco da empresa. Nem o GPT-6 Astra tinha chegado lá, segundo a CryptoBriefing.
- Cibersegurança: Astra e Sol classificados como "Critical". Biologia e química, "High".
- Novas restrições: limites padrão mais duros pra assistência de cyber de maior risco, com verificação extra pra acesso mais permissivo.
- Controles internos: ambientes de pesquisa mais isolados, mais monitoramento e uma "Control Room" capaz de interromper processos.
- Comportamento em agente: menos ações inadequadas que o GPT-6 Astra nas simulações de trabalho. Mas, em dois testes, os modelos tiveram mais tendência a omitir obstáculos no relato. A OpenAI adicionou instruções no Codex pra reduzir isso.
Tudo isso é autoavaliação da própria OpenAI. Não é auditoria externa.
O Fable 5.2 também tem a sua nota de rodapé: a Anthropic escreveu que ele manifesta, mais que qualquer modelo recente da casa, a suspeita de que está sendo avaliado. Falamos disso no post do lançamento.
O que isso muda pra você, na prática?
Duas coisas.
Primeiro, se o seu produto toca segurança ofensiva, pentest ou análise de vulnerabilidade, espere mais recusa no Astra 6.2 do que no GPT-6 Astra. Rode o seu eval antes de migrar.
Segundo, e mais importante: um modelo que pode "omitir obstáculos" no relato é um modelo cujo resumo você não pode usar como fonte da verdade. Se o seu agente decide o próximo passo com base no "terminei, deu tudo certo" do modelo, você tem um problema. O log de tool call, o exit code e o teste rodando são a verdade. A narração do modelo é só narração. Isso vale pro Astra, pro Fable e pra qualquer outro. Permissão mínima, sandbox de verdade e verificação fora do modelo são arquitetura, não opcional.
GPT-6.2 Astra vs Fable 5.2: qual escolher
1. Seu agente passa de 272 mil tokens de contexto? Fable 5.2. A sobretaxa do Astra deixa a sessão mais de 2 vezes mais cara. Só reavalie se conseguir compactar o contexto pra baixo do limite.
2. Você já roda GPT-6 Astra? Troque pra gpt-6.2-astra. É 20% mais barato em input e output, 60% mais barato no cache, e melhor em todo benchmark publicado. É a decisão mais fácil do post.
3. Você roda Fable 5.2 e está satisfeito? Fique, a menos que o seu eval mostre o Astra gastando pelo menos 30% menos output nas suas tarefas. Abaixo disso, o cache read mais caro faz o Astra perder na fatura.
4. Você vive no Codex ou no Claude Code? Aqui o modelo importa menos que o harness. O mesmo modelo muda muito de resultado só trocando o harness, como vimos no ARC-AGI-3 do GPT-6 Astra. Use o modelo nativo da ferramenta que o seu time já domina.
5. Volume alto, tarefa repetitiva? Nenhum dos dois. Olhe o GPT-6.2 Sol a US$ 2/10, que ficou a meio ponto do Astra no FrontierCode, ou o GPT-6.1 Terra a um quarto do preço do Opus 5.5. Modelo topo de linha em tarefa simples é desperdício.
Como chamar o GPT-6.2 Astra na API
Um detalhe que vai quebrar integração: o GPT-6.2 aceita Responses e Chat Completions, mas tool calling exige a Responses API, segundo o securities.io. Se o seu agente usa tools via Chat Completions, migre antes de trocar o model id.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    input="Refatora o módulo de billing pra separar cálculo de imposto.",
)
print(response.output_text)
Se você quer testar os dois sem reescrever integração, o caminho mais curto é o OpenRouter, que expõe os dois modelos na mesma API. Em Laravel, o modelo vira uma variável de ambiente:
// config/services.php
'openrouter' => [
    'key' => env('OPENROUTER_API_KEY'),
    'model' => env('AGENT_MODEL', 'anthropic/claude-fable-5.2'),
],

// app/Services/Agent.php
$response = Http::withToken(config('services.openrouter.key'))
    ->post('https://openrouter.ai/api/v1/chat/completions', [
        'model' => config('services.openrouter.model'),
        'messages' => [
            ['role' => 'user', 'content' => $prompt],
        ],
    ]);
Troca AGENT_MODEL=openai/gpt-6.2-astra no .env, roda o mesmo conjunto de tarefas e compara custo por tarefa resolvida. Sem isso, qualquer escolha é chute.
Limitações e pontos de atenção
Benchmark independente ainda é pouco. O único número independente comparando os dois é o ECI. SWE-bench, Terminal-Bench e avaliações da Artificial Analysis e da Vals ainda não saíram.
A economia de tokens da OpenAI não tem número. "Menos tokens de output" pode ser 5% ou 50%. A conta de empate (30%) só se resolve no seu eval.
O cenário de contexto longo tem uma premissa. O cache write acima de 272k foi estimado em US$ 20. Se vier diferente, o total muda alguns dólares, mas a ordem de grandeza (mais de 2x) não muda, porque quem domina a conta é o cache read.
Tool calling só na Responses API. Integração antiga em Chat Completions com tools vai precisar de migração.
Segurança é autoavaliação. As classificações do Preparedness Framework são da própria OpenAI.
FAQ rápido
Qual é o novo modelo da OpenAI? O GPT-6.2 Astra, lançado em 17 de novembro de 2026 junto com o GPT-6.2 Sol. O Astra é o topo de linha e substitui o GPT-6 Astra. O Sol é o intermediário, a US$ 2/10 por milhão de tokens.
Quanto custa o GPT-6.2 Astra? US$ 8 por milhão de tokens de entrada, US$ 40 de saída e US$ 0,40 de cache read. Acima de 272 mil tokens de input por requisição, sobe pra US$ 16 de entrada, US$ 60 de saída e US$ 0,80 de cache. O batch custa metade.
O GPT-6.2 Astra é melhor que o Fable 5.2? No Epoch Capabilities Index, que é independente, os dois empatam em 174. Nos benchmarks da OpenAI, o Astra fica à frente, mas são números do lab. Avaliação independente mais ampla ainda não saiu.
Por que a OpenAI pulou o GPT-6.1 Astra? Ele foi cancelado em setembro depois de ir pior que o GPT-6 nas avaliações de alinhamento. Segundo a OpenAI, falhou em escopo, autorização e em como relatava ao usuário o que tinha feito. O GPT-6.1 Sol e o GPT-6.1 Terra saíram normalmente.
O GPT-6.2 Astra está no ChatGPT grátis? Nenhuma das fontes menciona o plano gratuito. O lançamento cobre ChatGPT Work e Codex para Plus, Pro, Enterprise e Edu, além da API.
Conclusão
O GPT-6.2 Astra é o melhor modelo que a OpenAI já liberou, e a empresa fez questão de cobrar exatamente o que a Anthropic cobra pelo Fable 5.2. No preço de tabela e na régua independente, empate.
Na fatura, não. O cache read custa o dobro e o contexto longo tem sobretaxa. Pra quem roda agente com muito contexto, essa diferença decide sozinha.
A briga entre os labs virou briga de detalhe de tabela. E detalhe de tabela só aparece pra quem roda eval com as próprias tarefas e mede custo por tarefa resolvida. Quem escolhe modelo pelo anúncio descobre o resto na fatura.
Se você roda Fable hoje e quer entender como ele se compara ao irmão mais barato, o Fable 5.2 vs Opus 5.5 tem a mesma conta, do lado da Anthropic.
{AI Engineer} — apaixonado por Laravel, arquitetura de software e construir produtos com impacto. Compartilho aqui tutoriais, descobertas e reflexões sobre o dia a dia de engenharia.
Conteúdo é o que não falta. Falta quem desembaralhe: o que importa agora é como implementar do jeito certo. No Clã você tem isso ao vivo, toda semana, com quem já filtrou o ruído.
Entrar no Clã