Grok 4.7 responde em 0,85s e o Fable 5.1 em 298s: onde cada um compensa
O Grok 4.7 custa US$ 2 por milhão de tokens de entrada. O Claude Fable 5.1 custa US$ 10.
Cinco vezes mais barato.
E mesmo assim, no custo por tarefa concluída, ele perde pro GPT-6 Astra — que também cobra US$ 10.
Esse é o tipo de número que só aparece quando você para de olhar a tabela de preço e começa a olhar a conta fechada. Este post pega o Grok 4.7, lançado pela xAI em 21 de setembro de 2026, e responde a única pergunta que importa pra quem constrói produto: em que cenário esse modelo é a escolha certa — e em quais ele é a escolha cara disfarçada de barata.
Spoiler: existe um cenário onde ele não tem concorrente. E não é escrever código.
TL;DR
- O que é: Grok 4.7, modelo de fronteira da xAI (hoje SpaceXAI LLC), sucessor do Grok 4.6. Texto e imagem na entrada, texto na saída.
- Contexto e cutoff: 500 mil tokens, conhecimento até maio de 2026.
- Custo/Acesso: US$ 2 de entrada e US$ 6 de saída por milhão, cache de entrada a US$ 0,50. Acima de 200k tokens de prompt, tudo dobra. Disponível na API da xAI, no Cursor, no Grok Build e nos roteadores de modelo.
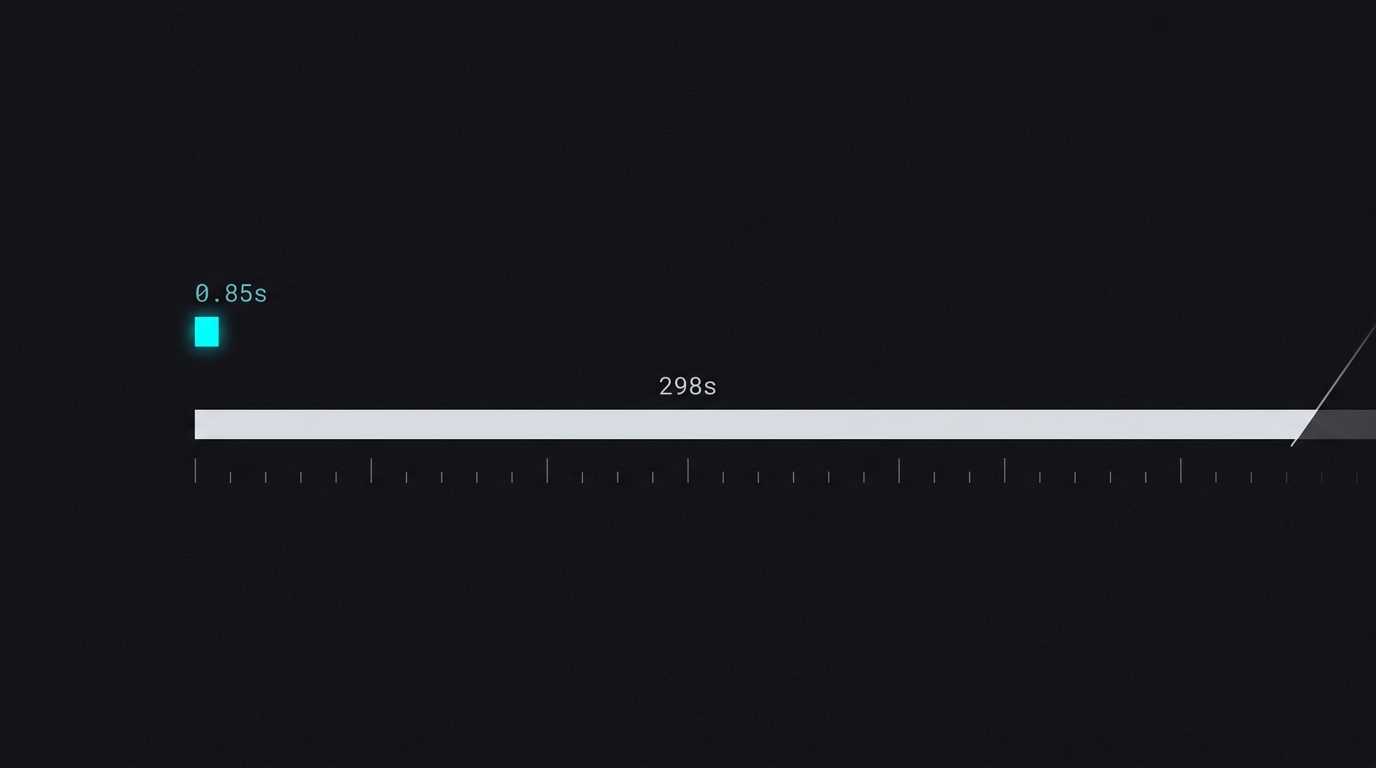
- Onde ele ganha: latência. Primeiro token em 0,85 segundo, contra 298 segundos do Fable 5.1 e 259 do GPT-6 Astra nas configurações de raciocínio máximo.
- Onde ele perde: tarefa agentic longa. No Terminal-Bench 4.0 ele faz 38,0% pela medição da própria xAI e 26% pela medição independente — contra 60% do GPT-6 Astra.
- Link útil: anúncio oficial | docs de modelos e preço
O que a xAI entregou em 21 de setembro
O anúncio é direto: modelo base maior, ciclo de reinforcement learning mais longo, treinado com peso maior em problemas que levam muitas horas pra resolver. A xAI diz que ele ficou "melhor em verificar o próprio trabalho e em gerenciar contexto longo".
Os números que a empresa publicou, sempre contra o Grok 4.6:
| Benchmark | Grok 4.7 | Grok 4.6 |
|---|---|---|
| CursorBench 4.0 | 46,3% | 40,4% |
| DeepSWE v1.1 | 71,0% | 65,2% |
| EEBench | 64,0% | 53,0% |
| Terminal-Bench 4.0 | 38,0% | 20,3% |
| Harvey Legal Agent | 19,6% | 15,8% |
| HealthBench Professional | 56,7% | 48,5% |
Salto real geração a geração. O Terminal-Bench quase dobrou.
Agora o detalhe que passou batido em praticamente toda a cobertura: o preço não mudou. US$ 2 de entrada e US$ 6 de saída por milhão de tokens são exatamente os mesmos valores do Grok 4.6, que estão publicados lado a lado na doc. Não houve corte, não houve promoção de lançamento. Você ganhou performance de graça, o que é bom — mas não confunda isso com "ficou mais barato", que é o que metade das manchetes sugeriu. (O OpenRouter lista o modelo a US$ 1,60/US$ 4,80, abaixo do preço oficial; se isso é política de roteador ou promoção, a xAI não diz.)
E um detalhe de rodapé que vale registrar porque ninguém em português registrou: o anúncio, a documentação e o catálogo do OpenRouter já não dizem "xAI". Dizem SpaceXAI LLC. A empresa passou a assinar com o nome novo junto com este lançamento.
Trocar o modelo do seu produto porque saiu número novo na timeline é o mesmo erro de escolher banco de dados por benchmark de blog: a decisão não está na tabela do fornecedor, está em rodar a sua tarefa nos dois e medir o custo por tarefa concluída. Esse tipo de medição feita na frente de todo mundo, com o número aparecendo na tela, é o que rola toda semana ao vivo no Clã Beer and Code.
O número que mais muda a decisão: 0,85 segundo
Esse é o dado que reposiciona o modelo inteiro.
Medição do Artificial Analysis, tempo até o primeiro token:
| Modelo | Time to first token |
|---|---|
| Grok 4.7 (xhigh) | 0,85 s |
| GPT-6 Astra (max) | 259,33 s |
| Claude Fable 5.1 | 298,45 s |
Não é erro de digitação. São quatro a cinco minutos.
E não é lentidão de rede. É raciocínio. Modelos como o Fable 5.1 e o GPT-6 Astra, nas configurações de esforço máximo, pensam antes de emitir o primeiro caractere. Para tarefa em lote, isso é irrelevante: você dispara e volta depois. Para qualquer coisa onde tem um ser humano esperando na frente de uma tela, isso é a diferença entre um produto e um relatório.
O Grok 4.7 responde em menos de um segundo.
É isso que define onde ele mora.
Onde o Grok 4.7 compensa
1. Qualquer coisa no caminho síncrono do request
Chat dentro do seu produto. Assistente que responde enquanto o usuário digita. Triagem de ticket antes de rotear. Classificação de intenção. Extração de campo em formulário. Sugestão em tempo real.
Todo esse território tem um orçamento de latência medido em segundos, não em minutos. Ali o índice de inteligência 46 do Grok 4.7 (posição 16 entre 202 modelos avaliados) é folgadamente suficiente, e os 0,85 segundo são decisivos. Colocar um modelo de raciocínio máximo nesse caminho não é sobre-engenharia — é quebrar o produto.
2. X search nativo: isso ninguém mais tem
A lista de ferramentas do Grok 4.7 na doc oficial inclui function calling, web search, code execution e X search. Busca no X como tool nativa do modelo, sem você montar scraper, sem API paralela, sem pipeline de ingestão.
Se o seu produto encosta em monitoramento de marca, análise de sentimento sobre evento ao vivo, detecção de tendência, due diligence sobre pessoa pública ou qualquer coisa onde o sinal nasce no X antes de virar notícia — esse é um diferencial funcional, não um número de benchmark. Nenhum modelo da OpenAI, da Anthropic ou do Google tem acesso nativo a essa base.
É, na prática, o caso de uso mais defensável do modelo hoje.
3. Contexto de 500k com cache a US$ 0,50
Meio milhão de tokens de janela, com entrada cacheada a US$ 0,50 por milhão — um quarto do preço da entrada normal.
Isso serve bem para padrão de prompt gordo e estável: system prompt grande com regra de negócio, base de documentos fixa, few-shot longo. Você paga caro uma vez e barato nas chamadas seguintes. Para um assistente interno que carrega o mesmo manual de 200 páginas em toda conversa, a conta fecha bem.
4. Reasoning como alavanca, não como chave
O modelo aceita quatro níveis de esforço: low, medium, high (default) e xhigh.
Isso importa mais do que parece, porque todos os números ruins que você vai ver na próxima seção foram medidos no xhigh. Se a sua tarefa não precisa de raciocínio profundo — e a maioria das tarefas de produto não precisa — descer para low ou medium corta token de saída, corta custo e corta latência ao mesmo tempo. O mesmo modelo vira outro produto econômico.
Onde ele não compensa
Agente de código de longa duração
Aqui o número é desconfortável, e ele vem em duas versões.
| Terminal-Bench 4.0 | Score | Fonte |
|---|---|---|
| Grok 4.7 | 38,0% | medição da própria xAI |
| Grok 4.7 | 26% | medição independente |
| DeepSeek V4.1 Flash | 27% | medição independente |
| Claude Fable 5.1 | 55% | medição independente |
| GPT-6 Astra | 60% | medição independente |
Os 12 pontos de diferença entre a medição da xAI e a de terceiros não são necessariamente má-fé. Terminal-Bench é benchmark agentic, e benchmark agentic depende de scaffold: o mesmo modelo muda de patamar dependendo do harness que o envolve. A xAI inclusive diz no anúncio que treinou o modelo para "entender nativamente o harness do Grok Bot" — o que explica boa parte do gap e, ao mesmo tempo, avisa que o número de 38% pode não te seguir pra fora do ambiente deles. Esse efeito a gente já tinha destrinchado no comparativo do DeepSeek V4.1 Flash, onde trocar o scaffold mexeu mais no resultado que trocar o modelo.
Mas nas duas leituras a conclusão prática é a mesma: em tarefa agentic longa de código, o Grok 4.7 está entre 17 e 22 pontos atrás dos líderes. Pela medição independente, ele empata com um modelo flash chinês que custa uma fração do preço.
Se o seu caso é agente rodando horas num repositório grande, ele não é a escolha.
Velocidade de saída, se o texto for longo
39,5 tokens por segundo no xhigh, contra 65,8 do Fable 5.1 e 65,3 do GPT-6 Astra.
Ou seja: ele começa rápido e continua devagar. Para resposta curta isso é ótimo, porque o que o usuário percebe é o primeiro token. Para geração de texto longo, o ganho de latência inicial vai sendo comido no meio do caminho.
Prompt acima de 200 mil tokens
O preço não é linear. Passou de 200k tokens de prompt, tudo dobra:
| Faixa de prompt | Entrada | Cache | Saída |
|---|---|---|---|
| Abaixo de 200k | US$ 2,00 | US$ 0,50 | US$ 6,00 |
| A partir de 200k | US$ 4,00 | US$ 1,00 | US$ 12,00 |
Se o seu padrão de uso vive na metade de cima da janela de 500k, você não está pagando US$ 2 por milhão. Está pagando US$ 4, com saída a US$ 12 — e aí a vantagem de preço contra os modelos premium encolhe bastante.
Não só acompanhe as novidades — domine. Engenharia de IA na prática, ao vivo, toda semana, na maior comunidade do Brasil.
Entrar no ClãA armadilha do preço por token
Agora a conta que resolve a discussão. O Artificial Analysis publica, além do preço de tabela, o custo por tarefa do índice de inteligência: quanto sai, em dólar, para o modelo completar o mesmo conjunto de avaliações.
| Grok 4.7 (xhigh) | GPT-6 Astra (max) | Claude Fable 5.1 | |
|---|---|---|---|
| Índice de inteligência | 46 (#16/202) | 53 (#3/202) | 53 (#1/202) |
| Preço entrada / saída | US$ 2 / US$ 6 | US$ 10 / US$ 50 | US$ 10 / US$ 50 |
| Primeiro token | 0,85 s | 259,33 s | 298,45 s |
| Saída | 39,5 tok/s | 65,3 tok/s | 65,8 tok/s |
| Custo por tarefa | US$ 3,74 | US$ 3,26 | US$ 7,63 |
Leia a última linha devagar.
O Grok 4.7 é cinco vezes mais barato por token que o GPT-6 Astra. E termina a mesma bateria de tarefas mais caro que ele: US$ 3,74 contra US$ 3,26.
O motivo é mecânico, não misterioso. O modelo compensa a diferença de capacidade gastando token: raciocina mais, tenta mais, verifica mais. Cinco vezes mais barato por unidade não adianta quando você consome seis vezes mais unidades pra chegar no mesmo lugar — e num lugar um pouco pior, já que o índice é 46 contra 53.
Contra o Fable 5.1 a história inverte: ali o Grok economiza metade (US$ 3,74 contra US$ 7,63). Então não é que ele seja caro. É que "barato por token" e "barato por tarefa" são duas métricas diferentes, e só a segunda aparece na sua fatura.
A regra que sai daqui é chata e vale pra qualquer modelo novo: preço de tabela é premissa, não conclusão. Rode a sua tarefa, conte os tokens gastos até a resposta aceita, divida. É a única medição que tem a ver com o seu produto.
Veredito por cenário
| Cenário | Escolha | Por quê |
|---|---|---|
| Chat/assistente dentro do produto, usuário esperando | Grok 4.7 (low ou medium) |
0,85 s até o primeiro token; índice 46 sobra pra essa tarefa |
| Triagem, classificação, extração no request path | Grok 4.7 (low) |
mesma razão, com custo de saída mínimo |
| Produto que lê sinal do X em tempo real | Grok 4.7 | X search nativo; não existe equivalente |
| Assistente com prompt fixo gigante e muitas chamadas | Grok 4.7 | cache de entrada a US$ 0,50 com janela de 500k |
| Agente de código rodando horas num repo grande | GPT-6 Astra ou Fable 5.1 | 60% e 55% no Terminal-Bench contra 26–38% |
| Raciocínio difícil, em lote, latência não importa | GPT-6 Astra | índice 53 e menor custo por tarefa (US$ 3,26) |
| Volume alto de tarefa simples, custo acima de tudo | modelo flash/barato | Grok 4.7 não é modelo de piso de preço |
O resumo em uma frase: o Grok 4.7 é um modelo de latência, não um modelo de fronteira. Ele compete onde o relógio manda, não onde a dificuldade manda.
Limitações e pontos de atenção
- Os benchmarks do anúncio comparam o 4.7 só com o 4.6. Não há tabela oficial contra Fable 5.1, GPT-6 Astra ou Gemini. Toda comparação cruzada deste post vem de medição de terceiros, com scaffold diferente do da xAI.
- Os dados de velocidade e custo por tarefa são do perfil
xhigh. Emlowoumediumo comportamento muda bastante — provavelmente pra melhor em custo e latência, pior em qualidade. Se você for usar esses níveis, meça, não extrapole. - A variante Grok 4.7 Fast existe, custa o dobro e é restrita ao Cursor e ao Grok Build. Não está na API aberta.
- Cutoff de conhecimento em maio de 2026. Para qualquer coisa posterior, você depende das tools de busca — o que é justamente onde o X search nativo pesa a favor.
- X search é um recurso, não uma garantia. Conteúdo do X é fonte primária ruidosa. Se o seu produto vai citar isso pro usuário final, camada de verificação não é opcional.
FAQ rápido
O Grok 4.7 é gratuito?
Na API, não: é cobrado desde o primeiro token, US$ 2 por milhão de entrada e US$ 6 de saída. O Grok Build tem um nível gratuito, mas a própria doc de preços da xAI registra que esse nível não inclui a variante Grok 4.7 Fast. Para uso em produto, trate o modelo como pago.
Quanto custa o Grok 4.7?
US$ 2 de entrada e US$ 6 de saída por milhão de tokens, com entrada cacheada a US$ 0,50. Passando de 200 mil tokens de prompt, tudo dobra: US$ 4, US$ 1 e US$ 12. São exatamente os mesmos valores do Grok 4.6 — o preço não caiu nesta geração, só a performance subiu.
Como acessar o Grok 4.7?
API da xAI com o model id grok-4.7, além de Cursor, Grok Build, roteadores como o OpenRouter e harnesses de código de terceiros. Aceita texto e imagem na entrada, texto na saída, com quatro níveis de esforço de raciocínio: low, medium, high e xhigh.
O que o Grok 4.7 faz de diferente dos outros modelos?
Duas coisas concretas. Ele responde o primeiro token em 0,85 segundo, contra minutos dos rivais premium em raciocínio máximo. E traz X search como ferramenta nativa — acesso que nenhum modelo da OpenAI, da Anthropic ou do Google tem.
Vale trocar meu agente de código pra ele?
Se o agente roda tarefa longa e autônoma, não. São 26% a 38% no Terminal-Bench 4.0 contra 60% do GPT-6 Astra. Se o seu "agente" é assistente interativo que responde na hora, aí vale testar — o perfil de latência é outro jogo. O critério por cenário está no comparativo de ferramentas de código.
Por que a xAI virou SpaceXAI?
A assinatura "SpaceXAI LLC" aparece no anúncio, na documentação e no catálogo do OpenRouter a partir deste lançamento. A empresa não publicou nota explicando a mudança societária junto com o modelo — o que dá pra afirmar hoje é que o nome mudou, não o que motivou.
O que fica de pé
O Grok 4.7 é um modelo bom sendo vendido pela métrica errada.
A xAI posicionou como "o mais capaz para código e trabalho de conhecimento", e os benchmarks de código são exatamente onde ele fica mais atrás. Enquanto isso, o número que realmente diferencia o modelo — primeiro token em 0,85 segundo, contra quatro minutos dos rivais premium — não aparece em nenhuma manchete, porque latência não rende gráfico bonito de barra.
Para quem constrói produto, é o contrário: latência é o que o usuário sente, e capacidade bruta é o que o engenheiro admira. As duas coisas raramente moram no mesmo modelo, e escolher a errada custa retenção.
A lição maior não é sobre o Grok. É que o preço por token virou métrica de marketing. US$ 2 contra US$ 10 parece decisão óbvia até você medir o custo por tarefa e descobrir que a conta fechada inverte. Isso vale para o próximo modelo barato que for anunciado, e vai ter um nas próximas semanas.
Se quiser ver o mesmo efeito com outro elenco, o comparativo do GPT-6 Astra, Fable 5.1 e GPT-5.6 Sol tem a conta de cache que deixa uma sessão de agente 54% mais cara sem ninguém perceber.
Registro: publicado em 22/09/2026, um dia depois do lançamento. Benchmarks de terceiros sobre modelo recém-lançado mudam nas primeiras semanas — este post é vivo e vai ser atualizado conforme surgirem medições independentes novas.
{AI Engineer} — apaixonado por Laravel, arquitetura de software e construir produtos com impacto. Compartilho aqui tutoriais, descobertas e reflexões sobre o dia a dia de engenharia.
Conteúdo é o que não falta. Falta quem desembaralhe: o que importa agora é como implementar do jeito certo. No Clã você tem isso ao vivo, toda semana, com quem já filtrou o ruído.
Entrar no Clã