Ox Alpha era o GLM-5.3-Flash: a Z.ai confirmou, abriu os pesos em MIT — e o benchmark de 80% continua falso
O Ox Alpha era o GLM-5.3-Flash. A Z.ai confirmou, os pesos estão no Hugging Face sob licença MIT, e o modelo que rodou uma semana de graça agora custa US$ 0,075 por milhão de tokens de entrada.
Cinco dias atrás, quando ninguém tinha assumido a autoria, publicamos aqui que a evidência do tokenizador apontava para a Zhipu — 95 probes de 95, erro médio zero contra o vocabulário do GLM-5. Escrevemos "alta confiança, não confirmado".
Agora está confirmado.
Neste post você vai ver como o benchmark de 80% se desfez, o método de US$ 0,00 que rastreou a autoria antes do anúncio, e o que o GLM-5.3-Flash entrega de fato agora que tem nome, preço e pesos abertos.
Atualização de 26/08/2026: o que mudou desde a publicação
Este post foi publicado em 25/08 com o modelo ainda anônimo. Em menos de 24 horas, três coisas aconteceram:
A Z.ai confirmou. Na quarta-feira, a empresa disse à Bloomberg que o Ox Alpha é uma nova iteração da série GLM e que os pesos sairiam naquela noite.
O modelo ganhou nome e preço. O stealth/ox-alpha saiu do catálogo do OpenRouter e reapareceu como z-ai/glm-5.3-flash. O acesso gratuito acabou: agora são US$ 0,075 por milhão de tokens de entrada e US$ 0,25 de saída, com 50% de desconto anunciado até 09/09. Leitura de cache a US$ 0,015.
Os pesos abriram. O zai-org/GLM-5.3-Flash foi publicado no Hugging Face em 26/08 sob licença MIT — a mais permissiva que existe, uso comercial liberado sem cláusula de uso aceitável.
E as notas de lançamento da Z.ai finalmente deram os números da arquitetura: 320 bilhões de parâmetros totais, 18 bilhões ativos, combinando atenção linear e esparsa, com visão nativa.
O resto do post continua valendo — inclusive o número que a gente mediu. Vale a pena ler a ordem em que as coisas aconteceram.
TL;DR
- O que é: GLM-5.3-Flash, modelo de raciocínio multimodal da Z.ai (Zhipu), focado em código e trabalho agêntico longo. Circulou anonimamente como "Ox Alpha" no OpenRouter entre 20/08 e 26/08.
- Arquitetura: 320B de parâmetros totais, 18B ativos. Atenção linear + esparsa combinada. Visão nativa.
- Specs: 1.048.576 tokens de contexto, até 131.072 de saída. Aceita texto, imagem e vídeo. Function calling e saída JSON.
- Custo: US$ 0,075 de entrada e US$ 0,25 de saída por milhão, com 50% off até 09/09. Era US$ 0,00 durante a fase stealth.
- Pesos: abertos no Hugging Face sob licença MIT.
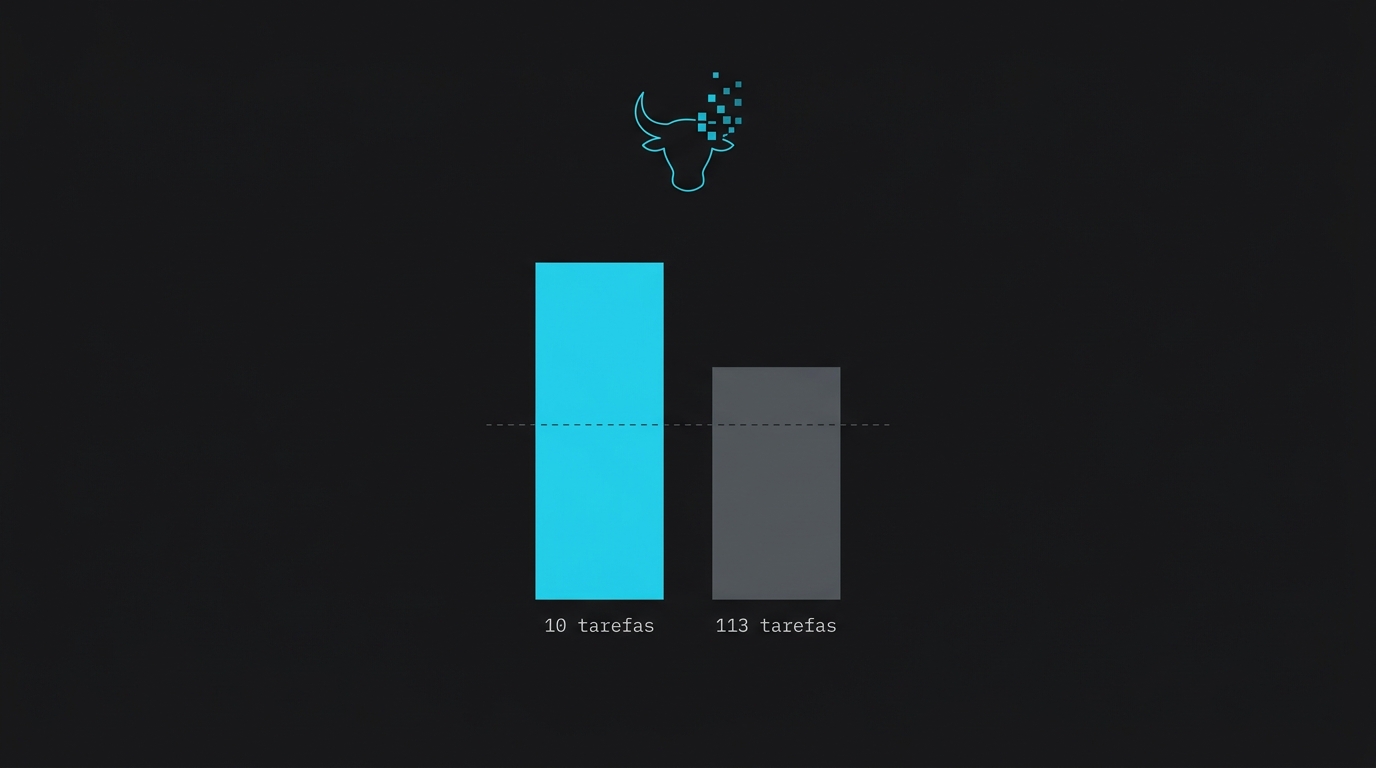
- Desempenho: ~63% no DeepSWE completo (113 tarefas) — não os 80% da manchete, que vieram de uma amostra de dez.
O benchmark que viralizou (e por que ele não sustentava a manchete)
A manchete nasceu de um teste no DeepSWE. Na amostra inicial, os números foram estes:
| Modelo | DeepSWE (amostra de 10 tarefas) |
|---|---|
| Ox Alpha | 80% |
| Claude Fable 5 | 65% |
| GLM-5.3 | 62% |
| Grok 4.6 | 62% |
| GPT-5.6 Sol | 52% |
Parece decisivo. Só que o DeepSWE tem 113 tarefas. Dez tarefas são menos de 9% do benchmark.
Com uma amostra desse tamanho, cada tarefa vale 10 pontos percentuais. Acertar uma a mais ou uma a menos move o resultado de 80% pra 70% ou 90%. Isso não é medição, é ruído com casas decimais.
Foi o que aconteceu quando rodaram o conjunto completo: duas execuções independentes das 113 tarefas ficaram perto de 63% — praticamente empatadas com o GPT-5.6 Sol, e não 15 pontos à frente do Claude Fable 5.
Esse número sobreviveu à confirmação. Nas discussões que se seguiram ao anúncio da Z.ai, os 63% no DeepSWE continuaram sendo a referência citada — não os 80%.
Tem uma segunda armadilha, mais silenciosa, nas tabelas que circularam: várias delas comparam o 80% do Ox Alpha no DeepSWE com os ~96% de Claude Opus 5 e GPT-5.6 Sol no SWE-bench Verified. São benchmarks diferentes, com dificuldade e metodologia diferentes. Colocar os dois na mesma coluna não é análise — é erro de planilha virando manchete.
A diferença entre engolir um gráfico e ler um gráfico é a mesma diferença entre usar IA e construir com IA. A segunda é a que a gente treina toda semana no Clã Beer and Code.
Nada disso significa que o GLM-5.3-Flash é ruim. 63% no DeepSWE é um modelo de fronteira com 1M de contexto, custando sete centavos e meio o milhão de tokens e com pesos abertos em MIT. É só bem diferente do que a manchete prometeu.
O tokenizador é uma impressão digital
Essa é a parte que merece atenção de quem gosta de engenharia — e que, com a confirmação da Z.ai, virou um caso fechado.
Nenhum laboratório assumia o Ox Alpha. Mas alguém descobriu a linhagem dele sem acesso a peso nenhum, usando um detalhe que praticamente toda API expõe: a contagem de tokens da fatura.
O método é elegante. Toda API de chat devolve usage.prompt_tokens. Se você mede a contagem de uma string-base e depois a contagem da mesma base mais um probe, o overhead do template de chat se cancela na subtração. O que sobra é exatamente quantos tokens aquele modelo gastou pra representar o seu probe.
tokens(base + probe) - tokens(base) = tokens do probe naquele tokenizador
Faça isso com dezenas de probes — idiomas diferentes, código, casos extremos de Unicode — e você tem uma assinatura. Tokenizador é vocabulário treinado: dois laboratórios diferentes praticamente nunca produzem contagens idênticas em toda a bateria.
O resultado do levantamento publicado foi 95 probes contra 14 vocabulários candidatos, em 126 chamadas de API, custando US$ 0,00 — porque o modelo estava de graça.
| Vocabulário testado | Correspondências exatas | Erro médio |
|---|---|---|
| GLM-4.5 (Zhipu) | 84 / 95 | 1,08 |
| Melhor não-GLM (Llama-3.1) | 46 / 95 | 3,83 |
| GLM-5 (vocabulário público) | 95 / 95 | 0,00 |
Noventa e cinco de noventa e cinco, com erro médio zero. Some a isso o comportamento do encoder de vídeo batendo com o GLM-5V-Turbo e a rejeição de áudio no estilo GLM, e a conclusão ficou difícil de contornar: família GLM, provavelmente uma variante multimodal não anunciada.
Era exatamente isso. O model card publicado pela Z.ai declara a arquitetura glm5_next e a tarefa image-text-to-text — multimodal, como o tokenizador sugeria.
Se o nome Zhipu te soa familiar, é porque a linha GLM já apareceu por aqui em outra história de perícia técnica.
As ressalvas — que o próprio método declara
Evidência forte não é confissão. O levantamento lista os próprios limites, e vale registrar quais deles a confirmação resolveu e quais continuam de pé:
Vocabulário identifica linhagem, não operador. O tokenizador diz de qual família o modelo descende. Não prova quem está servindo a API, nem que a empresa autorizou o lançamento. Aqui a confirmação da Z.ai fechou a lacuna — mas só neste caso.
É uma foto, não um filme. Mudança de template de chat ou de backend invalida medições anteriores. A leitura vale para o dia em que foi feita. Continua verdade.
O método é derrotável. Bastaria o provedor corromper os números de usage para embaralhar tudo. O que segura é o incentivo: transparência de faturamento é a única credibilidade que um provedor anônimo não pode abrir mão. Continua verdade.
A formulação honesta era "alta confiança, não confirmada". Cinco dias depois, a inferência virou fato. Isso não transforma o método em oráculo — transforma em evidência que se sustentou quando testada contra a realidade, que é o máximo que um método empírico pode oferecer.
Não só acompanhe as novidades — domine. Engenharia de IA na prática, ao vivo, toda semana, na maior comunidade do Brasil.
Entrar no ClãO que o GLM-5.3-Flash entrega na prática
As specs agora são oficiais, e estão no card do modelo no OpenRouter:
- Arquitetura: 320B de parâmetros totais, 18B ativos por token. Atenção linear combinada com esparsa.
- Contexto: 1.048.576 tokens de entrada, até 131.072 de saída.
- Modalidades: texto, imagem e vídeo na entrada; texto na saída. Visão nativa, com foco declarado em ler interfaces.
- Ferramentas: function calling via
tools/tool_choicee saída JSON viaresponse_format(sem enforcement de schema). - Preço: US$ 0,075 por milhão de entrada, US$ 0,25 de saída, US$ 0,015 de leitura de cache. Desconto de 50% anunciado até 09/09.
- Operação (medida ainda na fase stealth): 100% de uptime e 98,94% de sucesso em 72 horas, latência P50 de 4,34s e cerca de 27 tokens por segundo.
Dezoito bilhões de parâmetros ativos em 320B totais é a explicação do preço. Você paga pela computação de um modelo pequeno e recebe o conhecimento de um grande — é a mesma aposta arquitetural que o Qwen3.8-Flash-Next fez com 6B ativos em 125B totais, publicado na mesma semana.
Vinte e sete tokens por segundo é honesto, não impressionante. Para trabalho agêntico longo — o caso de uso que ele declara — throughput importa menos que estabilidade e janela de contexto, e nos dois ele entrega.
Atenção ao nome do modelo na chamada: o identificador antigo stealth/ox-alpha foi removido do catálogo e agora retorna erro. O correto é z-ai/glm-5.3-flash:
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "z-ai/glm-5.3-flash",
    "messages": [{"role": "user", "content": "Refatore esta função e explique o porquê."}]
  }'
Se você nunca usou a plataforma, tem um guia completo aqui.
Os pesos do GLM-5.3-Flash abriram em MIT: o detalhe que quase passou batido
A licença é a parte mais subestimada do anúncio.
O zai-org/GLM-5.3-Flash subiu no Hugging Face em 26/08 sob MIT. Não é "open weights com cláusula de uso aceitável", não é licença comunitária com teto de usuários, não é proibição de treinar modelo concorrente. É MIT: use, modifique, redistribua, venda, sem pedir licença a ninguém.
Para efeito de comparação, boa parte dos modelos abertos de peso pesado vem com restrições costuradas na licença. Um modelo de fronteira em MIT é raro.
A comunidade reagiu no ritmo esperado: em poucas horas depois da publicação já havia quantizações GGUF, versões MLX em 4, 6 e 8 bits e builds NVFP4 no Hugging Face. Se você roda local, provavelmente já existe uma variante no formato que você usa.
O que isso não resolve: 320B de parâmetros totais continuam sendo 320B para carregar. Os 18B ativos economizam computação por token, não memória. Quantização agressiva é o caminho para rodar isso fora de um servidor sério — e a conta de VRAM merece um post próprio.
Já vimos esse filme
Modelo sem dono, nome de bicho, preço zero, subindo no ranking antes de qualquer anúncio oficial. É um padrão, não um acidente.
Em abril de 2026 foi o Owl Alpha: rodou dois meses disfarçado, entrou no topo do OpenRouter em volume de chamadas, e só em junho a Meituan assumiu que era o LongCat-2.0. Contamos a história inteira aqui.
A mecânica é sempre a mesma, e é boa engenharia de produto: um laboratório precisa de tráfego real, com prompts reais, para avaliar um modelo antes do lançamento. Preço zero compra volume rápido. Anonimato remove o viés de marca — ninguém elogia porque é da Anthropic nem critica porque é chinês. E o ranking público vira uma eval gratuita, feita por milhares de devs.
O Ox Alpha chegou ao segundo lugar do OpenCode em três dias, e passou seis dias no ar antes de virar GLM-5.3-Flash. Como campanha de teste, funcionou perfeitamente.
O preço real do "de graça"
A janela fechou. O acesso gratuito durou de 20/08 a 26/08 — seis dias — e terminou com o modelo virando produto pago e o identificador antigo sumindo do catálogo, sem changelog. Exatamente como se esperava de um preview.
Se o seu código ainda aponta para stealth/ox-alpha, ele está quebrado agora. Troque para z-ai/glm-5.3-flash ou declare fallback com o array models na requisição.
E fica a lição da fase gratuita, que vale para o próximo modelo stealth que aparecer: você não pagava em dólar, pagava em prompt. Todo código enviado para um modelo sem dono declarado vai para um provedor que não se identificou, sob política de retenção que você não leu, num país que você não sabe qual é. Para brincar com código público, tanto faz. Para o repositório do cliente, era uma decisão de segurança tomada por omissão — e só depois se soube para quem os prompts foram.
FAQ
O GLM-5.3-Flash é melhor que o Claude Fable 5 para código? Pelos dados disponíveis, não. Empata com o GPT-5.6 Sol no DeepSWE completo (~63%). O 80% da manchete veio de uma amostra de dez tarefas e não se sustentou.
O Ox Alpha ainda existe?
Não. O identificador stealth/ox-alpha foi removido do OpenRouter em 26/08 e substituído por z-ai/glm-5.3-flash. É o mesmo modelo, com nome, preço e pesos.
Quanto custa o GLM-5.3-Flash? US$ 0,075 por milhão de tokens de entrada e US$ 0,25 de saída, com desconto de 50% anunciado até 09/09. Leitura de cache a US$ 0,015.
Dá para usar comercialmente? Agora sim. Os pesos estão sob licença MIT, e o modelo tem provedor identificado com preço publicado. Durante a fase stealth a resposta era não — sem laboratório identificado, não havia termos de uso, SLA nem garantia de continuidade.
Dá para rodar local? Os pesos estão no Hugging Face e a comunidade já publicou quantizações GGUF, MLX e NVFP4. Mas são 320B de parâmetros totais para carregar em memória: os 18B ativos reduzem computação por token, não o tamanho do modelo.
Por que um laboratório lançaria assim? Para conseguir eval em escala, com tráfego real e sem viés de marca, antes de comprometer a reputação da marca com um lançamento oficial.
O ponto
Duas lições aqui, e a segunda vale mais que a primeira.
A primeira: sempre pergunte o tamanho da amostra. Dez tarefas viraram uma manchete que atravessou o mundo, e bastou rodar o benchmark inteiro para o número cair 17 pontos. Seis dias depois, com o modelo já batizado e confirmado, os 63% seguem sendo o número real. Se um gráfico não diz quantas tarefas rodaram, em qual benchmark e com qual metodologia, ele não é evidência — é decoração.
A segunda: a informação mais confiável desse episódio não veio de anúncio nenhum. Veio de alguém subtraindo contagem de token de uma resposta de API, cinco dias antes de qualquer empresa abrir a boca. Enquanto a manchete discutia se o modelo era bom, um método de US$ 0,00 já respondia de quem ele era — e acertou.
É essa a diferença entre consumir notícia de IA e fazer engenharia de IA. Uma espera o anúncio. A outra mede.
{AI Engineer} — apaixonado por Laravel, arquitetura de software e construir produtos com impacto. Compartilho aqui tutoriais, descobertas e reflexões sobre o dia a dia de engenharia.
Conteúdo é o que não falta. Falta quem desembaralhe: o que importa agora é como implementar do jeito certo. No Clã você tem isso ao vivo, toda semana, com quem já filtrou o ruído.
Entrar no Clã