Kimi K3.1 Pro vs Claude Opus 5.5: metade do preço, 0,7 ponto atrás
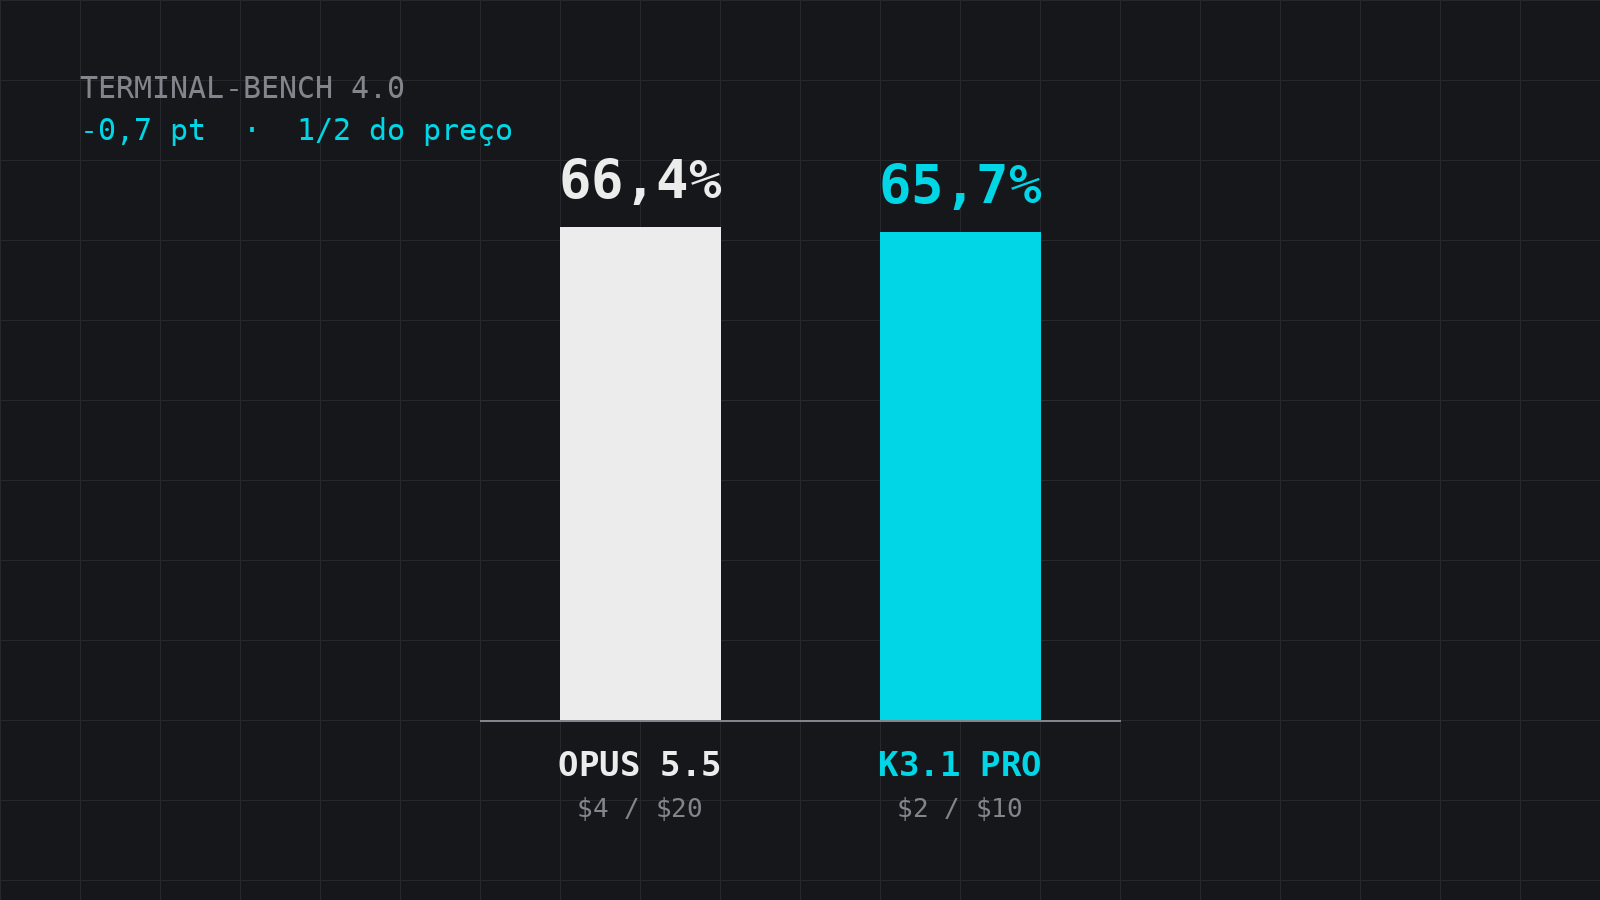
No duelo Kimi K3.1 Pro vs Opus 5.5, o modelo da Moonshot fica 0,7 ponto atrás no Terminal-Bench 4.0 (65,7% contra 66,4%) e cobra metade: US$ 2 / US$ 10 por milhão de tokens contra US$ 4 / US$ 20. É a primeira vez que um modelo que promete pesos abertos chega tão perto do Claude Opus 5.5 no benchmark de terminal.
O Kimi K3.1 Pro saiu na sexta, 23/10, e a timeline já decidiu que é "o Opus de graça". Calma.
A pegadinha está em três lugares: quem mediu, quanto token ele queima pra chegar no mesmo lugar, e o fato de que os pesos ainda não existem. Neste post a gente separa o que é verificado, o que é autodeclarado pela Moonshot e o que é promessa, faz a conta de custo de verdade e mostra como testar os dois no seu próprio workload antes de trocar qualquer coisa em produção.
Post vivo. A Moonshot prometeu os pesos abertos até 04/11/2026. Este texto será atualizado nesse dia com licença, formato e tamanho dos arquivos.
TL;DR
- O que é: Kimi K3.1 Pro, versão pós-treinada do Kimi K3 (MoE de 2,8T de parâmetros, 104B ativos), 1M de contexto, texto + imagem. Lançado em 23/10/2026.
- Benchmark-chave (autodeclarado): Terminal-Bench 4.0 65,7% contra 66,4% do Opus 5.5. 0,7 ponto de diferença.
- Custo: US$ 2 / US$ 10 por milhão de tokens (entrada/saída) contra US$ 4 / US$ 20 do Opus 5.5 (US$ 8 / US$ 40 em fast mode).
- Pesos abertos: prometidos até 04/11/2026. Licença não anunciada.
- Pegadinha: a Moonshot mesma mediu, o modelo é verboso, e os assinantes estão reclamando de cota queimando em minutos.
- Link útil: anúncio oficial e página no OpenRouter.
O que foi lançado (verificado)
O K3.1 Pro é o primeiro modelo da série K3.1. Segundo o anúncio da Moonshot, ele é um pós-treino do Kimi K3 com "substancialmente mais compute de pós-treinamento". A arquitetura é a mesma do K3: 2,8 trilhões de parâmetros no total, 104 bilhões ativos por token. A gente destrinchou essa base no post sobre os pesos abertos do Kimi K3.
Onde ele já roda:
- Kimi app (web, iOS, Android, HarmonyOS).
- Kimi Work, o app desktop, a partir da versão 3.1.0.
- Kimi Code, selecionando com
/model. - API, com dois IDs:
kimi-k3.1-proekimi-k3.1-pro-highspeed.
A variante Highspeed é 2 a 3 vezes mais rápida e, segundo o Simon Willison, custa o dobro. Ou seja: Kimi Highspeed sai pelo mesmo preço do Opus 5.5 padrão. Guarde essa informação, ela volta na conta de custo.
Contexto de 1M de tokens. Entrada de texto e imagem. Zero Data Retention disponível pra cliente de API. E no plano Business vem desligado por padrão: o admin precisa habilitar.
Kimi K3.1 Pro vs Opus 5.5 no benchmark: 65,7% contra 66,4% (autodeclarado)
Aqui mora o título do post. No Terminal-Bench 4.0, o benchmark que mais se aproxima de "agente de código rodando comando em terminal de verdade", a Moonshot reporta:
| Modelo | Terminal-Bench 4.0 |
|---|---|
| Claude Opus 5.5 | 66,4% |
| Kimi K3.1 Pro | 65,7% |
| GPT-6 Astra | 58,2% |
Fonte: anúncio da Moonshot, repercutido pelo The Next Web, que faz questão de marcar: todos os números são da própria Moonshot e não foram verificados.
Outros números que a Moonshot publicou:
- BenchCAD (com tools): 92,7% contra 96,2% do Opus 5.5. Sem tools, praticamente empate: 72,8% contra 73,0%.
- Taxa de alucinação no Kimi Hallu Bench Hard (sem tools): 5,4% contra 6,8% do Opus 5.5. Benchmark interno, e a própria Moonshot avisa que é stress test, não taxa de erro do dia a dia.
- Kimi Code Bench 3.0 Long-horizon (interno): 61,2%, contra 55,95% do K3.
Todos rodados com reasoning effort "max", temperatura 1.0 e top-p 0.95.
Agora o contraponto independente. O índice agregado da Artificial Analysis dá 55 para o Kimi K3.1 Pro e 58 para o Opus 5.5. Na frente de Fable 5.1, GPT-6 Astra e Gemini 4 Argon (todos com 53), mas não colado no Opus. São 3 pontos, não 0,7.
Leitura honesta: no recorte que a Moonshot escolheu, empate técnico. No agregado independente, o Opus segue na frente com folga. Os dois fatos são verdadeiros ao mesmo tempo, e é exatamente por isso que benchmark de lab nunca é argumento suficiente pra migrar.
Trocar de modelo a cada lançamento porque um gráfico mudou é a versão 2026 de ser dependente de ferramenta. Quem ganha nesse jogo é quem tem eval próprio, harness que troca de provider por configuração e métrica de custo por tarefa. É o tipo de coisa que o pessoal do Clã Beer and Code constrói toda semana, ao vivo: agente, RAG e eval rodando em produção, não em slide.
Kimi K3.1 Pro preço: metade do preço não é metade da conta
No papel:
| Modelo | Entrada (US$/MTok) | Saída (US$/MTok) |
|---|---|---|
| Kimi K3.1 Pro | 2 | 10 |
| Kimi K3.1 Pro Highspeed | 4 | 20 |
| Claude Opus 5.5 | 4 | 20 |
| Claude Opus 5.5 (fast mode) | 8 | 40 |
Preços do Kimi via OpenRouter (moonshotai/kimi-k3.1-pro) e Simon Willison. Do Opus 5.5, o preço de lista da Anthropic, que já comparamos no post Gemini 4 Argon vs Claude Opus 5.5.
Exatamente metade. Mas preço por token não é preço por tarefa.
Na discussão do Hacker News, um comentarista apontou que o Kimi gastou cerca de 150M de tokens pra rodar o índice da Artificial Analysis, contra uma mediana de 87M. Se isso se confirmar no seu caso, o modelo fala ~1,7x mais pra chegar na mesma resposta. Outro usuário fez a conta e chegou a uma vantagem real de ~2,5x no melhor cenário contra os "5x mais barato" que circularam no X, e muitas vezes bem menos.
Uma simulação simples de um dia de agente de código, com 10M de tokens de entrada e 1M de saída no Opus:
Opus 5.5:           10M × $4  + 1,0M × $20 = $40 + $20 = $60
Kimi K3.1 Pro:      10M × $2  + 1,7M × $10 = $20 + $17 = $37   (saída 1,7x mais verbosa)
Kimi Highspeed:     10M × $4  + 1,7M × $20 = $40 + $34 = $74
Opus 5.5 fast mode: 10M × $8  + 1,0M × $40 = $80 + $40 = $120
Três leituras:
- Em workload agentic, a entrada domina. É aí que o Kimi economiza de verdade.
- A verbosidade come parte da vantagem na saída. Os 50% viram uns 38% nesse exemplo.
- Se você precisa de velocidade, o Highspeed custa mais que o Opus padrão com a verbosidade na conta. Não existe almoço grátis.
E isso tudo antes de cache, que muda a conta inteira dos dois lados. Faça com os seus números.
Cota queimando e o pedido de desculpas (só no X)
Esse ponto é importante e precisa de um aviso: até a publicação deste post, a informação só circulou no X, sem cobertura em portal.
No X, a Moonshot pediu desculpas pelos limites duros e pela queima acelerada de cota no K3.1 Pro e anunciou a devolução de 25% da cota mensal em todos os planos.
O que dá pra confirmar fora do X são os relatos de usuário. No Hacker News, assinantes contam que o plano de US$ 20 durou "quinze, talvez vinte minutos no máximo" antes de bater o limite de 5 horas, e que um assinante do plano de US$ 40 também estourou rápido. Outro diz que a cota vem encolhendo desde o K2.7.
Juntando com a verbosidade: o modelo fala muito, a cota é contada em token, e a assinatura acaba antes da tarde. Pra uso em app ou Kimi Code, isso pesa mais que o preço da API. O próprio fio do HN levanta que as assinaturas da OpenAI e da Anthropic entregam mais valor que as APIs delas, e que a do Kimi não.
Não só acompanhe as novidades — domine. Engenharia de IA na prática, ao vivo, toda semana, na maior comunidade do Brasil.
Entrar no ClãCyber reduzido de propósito (autodeclarado)
Esse é o detalhe mais interessante do lançamento, e o menos comentado.
A Moonshot diz que removeu dados de ataque cibernético do mid-training e do RL antes da versão open-weight, mantendo os dados gerais de código. O motivo, nas palavras repercutidas pelo The Next Web: modelo aberto não tem recall depois que alguém baixa.
Os números, todos internos, no xdev-bench-hard (pass@3):
- K3.1 Pro lançado: 81,0%.
- Mesmo checkpoint sem a redução: 90,5%.
- Kimi K3: 33,3%.
A Moonshot afirma que a capacidade de ciber do K3.1 Pro "segue atrás dos modelos proprietários de fronteira" disponíveis há pelo menos três meses.
Pra quem já usou o Kimi K3 pra corrigir falha que Codex e Fable recusaram, isso é um sinal de mudança. Se o seu caso de uso é pentest autorizado ou análise de vulnerabilidade, teste antes. O modelo novo pode ser menos capaz justamente onde o antigo te ajudava.
Kimi K3.1 pesos abertos até 04/11 (promessa)
"Full model weights will be released by Nov 4, 2026." Está no anúncio. Licença: não anunciada.
O histórico ajuda a calibrar. No K3, a Moonshot anunciou em 16/07 e liberou os pesos em 27/07, um dia antes do prometido, com licença MIT modificada. Isso conta a favor. Mas até os arquivos estarem no Hugging Face, é promessa.
E mesmo com pesos, a conta de hardware é a mesma do K3: são ~1,4 TB só pra carregar os pesos. Os 104B ativos ajudam na velocidade, não na memória. Não é modelo pra rodar no notebook. É modelo pra quem tem cluster, ou pra provider terceiro hospedar mais barato.
Dois pontos de contexto que você não deve ignorar:
- Em julho a Casa Branca acusou a Moonshot de usar chips Nvidia banidos e de copiar um modelo da Anthropic pra construir o K3, sem publicar evidência (The Next Web). Depois veio o relatório da Anthropic sobre a Moonshot.
- No HN, usuários relatam que o K3.1 Pro às vezes se identifica como ChatGPT ou Claude. Isso não prova destilação (dado de chat comum no treino explica também), mas é ruído que o seu jurídico vai perguntar.
Risco regulatório pra quem roda em produção no Brasil a gente mapeou em sanções à IA chinesa open source.
Mão na massa: teste os dois no seu workload
Benchmark de lab responde a pergunta do lab. Você precisa responder a sua. O caminho mais barato é usar o OpenRouter, que expõe os dois com a mesma API compatível com OpenAI.
Passo 1: chamada direta no Kimi
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/kimi-k3.1-pro",
    "messages": [
      {"role": "user", "content": "Escreva um teste Pest para um endpoint POST /orders que valida estoque."}
    ]
  }'
A resposta traz usage com tokens de entrada e saída. É esse campo que importa pra comparar custo por tarefa, não o preço de lista.
Passo 2: troca de modelo por configuração em Laravel
Nada de if ($modelo === 'kimi') espalhado pelo código. O modelo vira config:
// config/llm.php
return [
    'model' => env('LLM_MODEL', 'anthropic/claude-opus-5.5'),
    'base_url' => 'https://openrouter.ai/api/v1',
    'key' => env('OPENROUTER_API_KEY'),
];
// app/Services/LlmClient.php
use Illuminate\Support\Facades\Http;

class LlmClient
{
    public function chat(array $messages, ?string $model = null): array
    {
        $response = Http::withToken(config('llm.key'))
            ->timeout(120)
            ->retry(3, 2000, throw: false)
            ->post(config('llm.base_url').'/chat/completions', [
                'model' => $model ?? config('llm.model'),
                'messages' => $messages,
            ])
            ->throw()
            ->json();

        return [
            'content' => $response['choices'][0]['message']['content'],
            'input_tokens' => $response['usage']['prompt_tokens'],
            'output_tokens' => $response['usage']['completion_tokens'],
        ];
    }
}
Trocar de provider vira uma linha no .env. Voltar atrás também.
Passo 3: eval de 20 casos com custo por tarefa
Pegue 20 tarefas reais do seu backlog (bug corrigido, teste escrito, migration revisada) com critério de aceite objetivo. Rode nos dois modelos e anote acerto e custo:
$precos = [
    'moonshotai/kimi-k3.1-pro' => ['in' => 2, 'out' => 10],
    'anthropic/claude-opus-5.5' => ['in' => 4, 'out' => 20],
];

foreach ($precos as $model => $p) {
    $acertos = 0;
    $custo = 0;

    foreach ($casos as $caso) {
        $r = app(LlmClient::class)->chat($caso['messages'], $model);
        $acertos += $caso['check']($r['content']) ? 1 : 0;
        $custo += ($r['input_tokens'] * $p['in'] + $r['output_tokens'] * $p['out']) / 1_000_000;
    }

    printf("%s: %d/%d acertos, US$ %.4f, US$ %.4f por acerto\n",
        $model, $acertos, count($casos), $custo, $custo / max($acertos, 1));
}
A métrica que decide é custo por acerto, não custo por token. Um modelo que custa metade mas erra o dobro sai mais caro, porque o retrabalho é seu.
Erros comuns nesse teste: rodar só 3 casos e tirar conclusão, comparar com temperatura diferente, e esquecer que o rate limit do Kimi pode cortar no meio do lote (o retry acima ajuda, mas loga quando acontecer).
Limitações e pontos de atenção
- Benchmark autodeclarado. O 65,7% vs 66,4% é da Moonshot. O único agregado independente disponível dá 55 vs 58.
- Verbosidade. Mais tokens de saída comem parte da vantagem de preço e, nos planos de assinatura, queimam cota.
- Cota instável. O pedido de desculpas e a devolução de 25% circularam só no X. Não planeje fluxo de trabalho diário em cima de uma cota que muda toda versão.
- Cyber reduzido de propósito. Bom pro ecossistema, possivelmente ruim pro seu caso de segurança defensiva. Teste.
- Pesos ainda não existem. E sem licença anunciada, você não sabe se pode hospedar comercialmente.
- Dados de cliente. A API da Moonshot oferece Zero Data Retention pra cliente de API. Via OpenRouter, confira a política do provider que vai servir o request. Sem isso, mascare antes de mandar.
FAQ rápido
O Kimi K3.1 Pro é melhor que o Claude Opus 5.5?
Não, pelos dados disponíveis. Ele chega perto no Terminal-Bench 4.0 (65,7% vs 66,4%, números da Moonshot) e fica 3 pontos atrás no índice da Artificial Analysis (55 vs 58). Pra muita tarefa de código o empate técnico é real. A vantagem dele é preço, não qualidade.
Quanto custa o Kimi K3.1 Pro?
US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, no OpenRouter e na API da Moonshot. A variante Highspeed custa o dobro: US$ 4 / US$ 20, igual ao Opus 5.5 padrão. Pelo HN, a vantagem real por tarefa fica em até ~2,5x por causa da verbosidade.
Quando saem os pesos abertos do Kimi K3.1?
A Moonshot prometeu até 04/11/2026, sem anunciar licença. No K3 ela entregou um dia antes do prazo, com licença MIT modificada. Este post será atualizado no dia 04/11 com o que for publicado.
Dá pra rodar o Kimi K3.1 Pro local?
Na prática, não em máquina de dev. São 2,8T de parâmetros e cerca de 1,4 TB de memória só pros pesos. Os 104B ativos aceleram a inferência, mas não reduzem a memória necessária. O caminho realista é API ou provider terceiro hospedando os pesos.
Conclusão
O Kimi K3.1 Pro é o modelo aberto (ou quase) mais perto do Opus que já apareceu. No recorte de terminal, 0,7 ponto. No agregado, 3. Pela metade do preço por token, mas não pela metade do preço por tarefa.
O que muda pra quem constrói: a distância entre aberto e fechado virou uma questão de custo e operação, não de capacidade bruta. Quem tem eval próprio e troca de modelo por .env captura essa economia. Quem migra por gráfico de lançamento descobre a verbosidade, a cota e o rate limit em produção.
Dia 04/11 a gente volta aqui com os pesos. Enquanto isso, vale revisitar como o Kimi K3 se saiu contra o Claude pra ver o quanto o salto do K3.1 foi pós-treino e o quanto foi marketing.
{AI Engineer} — apaixonado por Laravel, arquitetura de software e construir produtos com impacto. Compartilho aqui tutoriais, descobertas e reflexões sobre o dia a dia de engenharia.
Conteúdo é o que não falta. Falta quem desembaralhe: o que importa agora é como implementar do jeito certo. No Clã você tem isso ao vivo, toda semana, com quem já filtrou o ruído.
Entrar no Clã