Elorian Glimpse: o VLM que olha a imagem de novo antes de responder
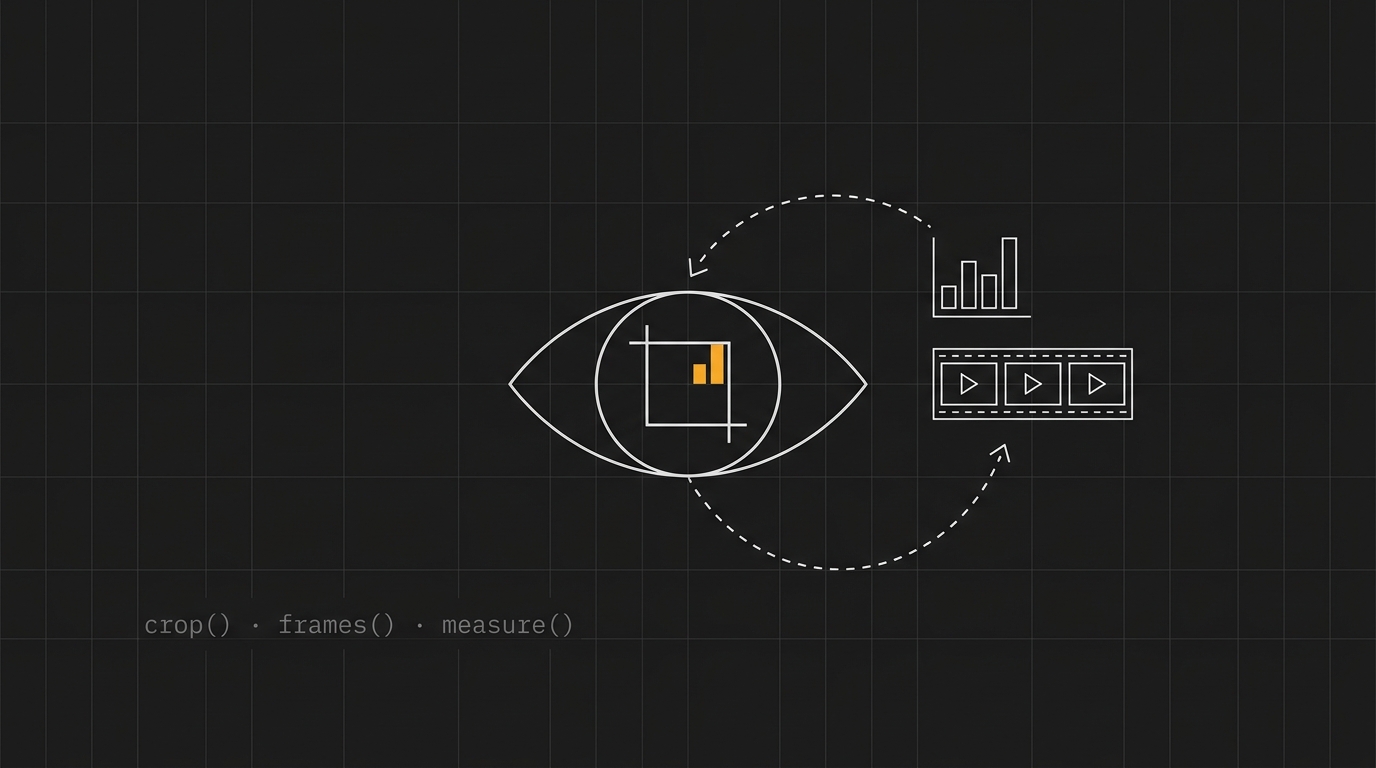
Todo VLM que você usa hoje olha a imagem uma vez e depois raciocina em cima do resumo que ele mesmo escreveu. O Elorian Glimpse é o primeiro que volta pra olhar de novo, e isso muda onde visão computacional com LLM quebra em produção.
O Glimpse é o primeiro modelo da Elorian, uma startup de Palo Alto fundada por ex-pesquisadores do Google DeepMind. Saiu em 16 de outubro de 2026 como research preview. A ideia é simples de explicar e difícil de fazer: em vez de transformar a imagem em texto e esquecer dela, o modelo recorta região, puxa frame específico de vídeo e roda código pra medir, tudo no meio do raciocínio.
Neste post você vai ver o defeito que o Glimpse ataca, como o tal "visual scratch space" funciona, os benchmarks que a Elorian publicou (inclusive onde ele perde), quanto custa, como chamar hoje e onde vale testar no seu produto.
TL;DR
- O que é: Glimpse, um vision language model (VLM) de raciocínio visual da Elorian. Entra texto, imagem e vídeo. Sai só texto.
- A tese: o modelo revisita a evidência visual enquanto pensa, em vez de raciocinar sobre a própria descrição da imagem.
- Benchmarks: todos reportados pela Elorian, no esforço máximo de raciocínio. São 12 testes, 11 deles com nota do GPT-6 Astra: o Glimpse supera o Astra em 4, empata em 1 e perde em 6. Nenhuma avaliação independente publicada até agora.
- Custo/Acesso: US$ 0,60 por milhão de tokens de entrada e US$ 3 de saída, segundo a Elorian. API própria, catálogo da OpenRouter (
elorian/glimpse) e endpoint dedicado na Together AI, por enquanto em lista de espera. - Status: research preview. Não é pra colocar no caminho crítico de produção amanhã.
O defeito de fábrica dos VLMs: ver uma vez, alucinar depois
Pra entender o Glimpse, primeiro precisa entender o que um VLM, um vision language model, faz hoje.
O fluxo padrão é assim: a imagem passa por um encoder visual, vira um punhado de tokens, e esses tokens entram no contexto junto com o seu prompt. A partir daí, o modelo é um LLM como qualquer outro, prevendo o próximo token. Se você quer o fundamento de como isso funciona por baixo, o nosso post sobre o que é um LLM explica do jeito que importa pra quem constrói.
O problema está no "uma vez".
A imagem é codificada no começo. Depois, o raciocínio inteiro acontece em texto. Quando o modelo "pensa" sobre o gráfico, ele está pensando sobre a descrição que ele mesmo gerou do gráfico, não sobre o gráfico. Se ele leu errado o eixo Y na primeira passada, o raciocínio todo é construído em cima do erro. Com muita confiança.
É por isso que VLM erra contagem. Erra leitura de valor em gráfico denso. Confunde corte de câmera com movimento de câmera em vídeo. Não é falta de inteligência. É falta de evidência na hora que ela importa.
O Andrew Dai, CEO da Elorian, contou ao TechCrunch a origem da ideia: fotografou um jogo de tabuleiro que tinha acabado de jogar e perguntou a um modelo de fronteira quem estava ganhando. O modelo não soube responder. Jogo de tabuleiro, diz ele, tem linguagem visual própria, com ícone e símbolo que não viram texto fácil. "Humanos conseguem olhar um manual da Ikea, sem texto, e montar o móvel. Por que os modelos de IA não conseguem?"
O time por trás disso tem pedigree. Dai passou 12 anos no Google DeepMind, a equipe tem gente que trabalhou no Gemini e no MM-1 da Apple, e a empresa levantou US$ 55 milhões numa rodada seed liderada por Striker, Menlo Ventures e Altimeter, com participação da NVIDIA e do Jeff Dean.
Pedigree não é prova. Mas explica por que o lançamento merece atenção.
E aqui vai o ponto prático: quem trabalha com visão computacional usando LLM já sabe que o problema raramente é o modelo. É o pipeline em volta dele: recortar antes de mandar, validar a saída, medir onde erra. Esse tipo de pipeline multimodal a gente monta ao vivo, toda semana, no Clã Beer and Code, que é a comunidade paga da Beer and Code onde a construção acontece junto, e não em aula gravada.
Como o Elorian Glimpse funciona: o "visual scratch space"
A Elorian chama o mecanismo de "visual scratch space". Em vez de olhar uma vez, o Glimpse ganha um rascunho visual onde pode voltar à imagem quantas vezes precisar durante o raciocínio.
Segundo o anúncio oficial e a cobertura do TechCrunch, ele pode:
- Dar zoom e recortar regiões. Leu um rótulo pequeno? Volta, recorta, lê de novo em resolução maior.
- Revisitar trechos de vídeo com amostragem densa. O exemplo da Elorian mostra o modelo reassistindo um intervalo subindo de cerca de 8 para 14 frames por segundo, pra entender um movimento rápido.
- Rodar código pra medir. Medir distância, comparar posição, rastrear um ponto ao longo dos frames. Em vez de "achar" que o trem está desacelerando, ele acompanha a borda de uma janela frame a frame e calcula.
- Coordenar subagentes que trocam texto, artefatos visuais e representações internas entre si.
Isso tudo foi treinado de ponta a ponta. Não é um agente que você monta com ferramentas em volta de um VLM comum.
Vale o contexto honesto: a ideia não é inédita. A OpenAI colocou crop-and-zoom no raciocínio dos modelos da série o em 2025, como lembra o TechCrunch. A diferença que a Elorian reivindica é ter construído isso no modelo inteiro, como capacidade nativa, e não como ferramenta encaixada.
Outro detalhe que importa pra custo: segundo a empresa, o Glimpse foi pós-treinado em cima de um modelo base de pesos abertos, por um time pequeno, com "apenas algumas centenas de GPUs". E é substancialmente menor que os modelos de fronteira contra os quais ele se compara. Menor costuma significar mais barato. Já chegamos lá.
Os benchmarks que a Elorian publicou (e por que nenhum é independente ainda)
Primeiro, a letra miúda. Todos os números abaixo vêm da página da Elorian. Os modelos rodaram no esforço máximo de raciocínio, cada um com seu harness nativo. GPT-6 Astra, GPT-6.1 Sol e Claude Opus 5.5 com Code Interpreter. Em boa parte dos testes de vídeo, Sol e Opus rodaram em esforço high, não max. E até a data deste post, eu não encontrei nenhuma avaliação independente reproduzindo esses números.
Dito isso, a tabela:
| Benchmark | O que mede | Glimpse | GPT-6 Astra | GPT-6.1 Sol | Opus 5.5 |
|---|---|---|---|---|---|
| WGO Bench | Robótica (eventos de manipulação) | 42,70 | 39,42 | 38,91 | 12,34 |
| ERQA | Robótica | 83,75 | 83,75 | 82,45 | 82,20 |
| BabyVision | Percepção visual | 95,36 | 97,68 | 97,16 | n/d |
| HSS | Entendimento de cena | 46,36 | 53,60 | 46,60 | 49,81 |
| CharXiv-R | Raciocínio em gráfico científico | 92,90 | 92,10 | 92,60 | 93,40 |
| UGC-VideoCap | Legenda de vídeo curto | 82,66 | 80,32 | 80,41 | 76,35 |
| DREAM-1K | Legenda de vídeo | 76,04 | 79,05 | 77,93 | 72,05 |
| TOMATO | Raciocínio temporal | 93,60 | 96,02 | 89,02 | 72,44 |
| Video-MME v2 | Raciocínio temporal | 56,68 | 64,06 | 65,27 | n/d |
| E.T. Bench | Raciocínio temporal | 63,55 | n/d | 59,79 | n/d |
| FSC-147 | Contagem | 83,36 | 82,02 | 82,69 | 73,78 |
| CountQA | Contagem | 82,66 | 86,42 | 86,42 | 82,20 |
Lendo com calma:
- A manchete é verdade, mas estreita. O Glimpse supera o GPT-6 Astra em gráfico científico (CharXiv-R) e legenda de vídeo curto (UGC-VideoCap), como diz o TechCrunch. Também ganha em WGO Bench e FSC-147, e empata no ERQA.
- Ele perde em mais testes do que ganha. Contra o Astra, perde em BabyVision, HSS, DREAM-1K, TOMATO, Video-MME v2 e CountQA. Em vídeo longo e raciocínio temporal pesado, o Astra e o Sol ficam na frente.
- O E.T. Bench fica fora da conta. A Elorian não publicou nota do Astra nesse teste. O Glimpse lidera a linha, mas por pouco: 63,55 contra 63,45 do Gemini 3.8 Flash.
- No CharXiv-R, quem lidera é o Opus 5.5, com 93,40. O Glimpse ganha do Astra, não da tabela.
- As diferenças são pequenas. 92,90 contra 92,10 está dentro do que harness, prompt e versão do teste mexem.
A leitura que eu faço: o Glimpse não é o melhor modelo de visão do mundo. É um modelo menor que chega perto dos maiores em visão, ganhando justamente nas tarefas onde "olhar de novo" faz diferença: contar, medir, ler detalhe de gráfico, descrever vídeo curto com precisão.
Faz sentido com a tese. E falta alguém de fora confirmar.
Não só acompanhe as novidades — domine. Engenharia de IA na prática, ao vivo, toda semana, na maior comunidade do Brasil.
Entrar no ClãQuanto custa e como chamar hoje (OpenRouter / Together)
O preço é o argumento mais forte do lançamento. Segundo a página oficial:
| Modelo | Input (1M tokens) | Output (1M tokens) |
|---|---|---|
| Elorian Glimpse | US$ 0,60 | US$ 3,00 |
| Gemini 3.8 Flash (preço introdutório) | US$ 0,75 | US$ 3,75 |
| GPT-6.1 Sol | US$ 2,00 | US$ 10,00 |
| Claude Opus 5.5 | US$ 4,00 | US$ 20,00 |
| GPT-6 Astra | US$ 10,00 | US$ 50,00 |
Na prática: 94% mais barato que o Astra, 85% mais barato que o Opus 5.5 e 70% mais barato que o Sol, no preço de tabela.
Uma conta de guardanapo (minha, com número hipotético): ler um gráfico com uns 3 mil tokens de entrada e 8 mil de saída, contando o raciocínio. No Glimpse dá cerca de US$ 0,026. No Astra, cerca de US$ 0,43. A própria Elorian mostrou algo parecido num teste de planejamento de robô: US$ 0,035 por episódio contra US$ 0,249 do Astra.
Só que tem um porém que a Elorian mesmo admite: revisitar a imagem custa tempo e token. Eficiência de token é a próxima prioridade declarada da empresa. Ou seja, o preço por token é baixo, mas o modelo pode gastar mais tokens por tarefa. Meça custo por tarefa resolvida, não por milhão.
Onde chamar:
- API e chat da própria Elorian, com trial gratuito na plataforma (o chat está liberado aos poucos pra quem está na lista de espera).
- OpenRouter, como
elorian/glimpse, pela API compatível com OpenAI. A doc avisa que o modelo não está disponível no roteamento in-region da União Europeia. - Together AI, só como deployment dedicado. A página está em "Launching soon", com lista de espera.
Uma chamada mínima em Laravel pela OpenRouter, mandando um gráfico pra ler:
use Illuminate\Support\Facades\Http;

$imagem = base64_encode(file_get_contents(storage_path('app/graficos/vendas-q3.png')));

$resposta = Http::withToken(config('services.openrouter.key'))
    ->timeout(300) // raciocínio visual em esforço alto pode demorar
    ->post('https://openrouter.ai/api/v1/chat/completions', [
        'model' => 'elorian/glimpse',
        'messages' => [[
            'role' => 'user',
            'content' => [
                ['type' => 'text', 'text' => 'Qual o valor da barra de setembro? Responda só o número e a unidade.'],
                ['type' => 'image_url', 'image_url' => ['url' => "data:image/png;base64,{$imagem}"]],
            ],
        ]],
    ])
    ->throw()
    ->json('choices.0.message.content');
Antes de plugar, confira na página do modelo na OpenRouter quais modalidades o provedor aceita por lá, principalmente vídeo, e qual o limite de contexto. Isso não estava documentado na data deste post.
Onde testar no seu produto (e onde não vale trocar)
Raciocínio visual com IA não é uma categoria só. Separando pelo que os números e a arquitetura sugerem:
Vale testar:
- Leitura de gráfico e dashboard. É onde a tese de olhar de novo mais rende, e o CharXiv-R confirma. Relatório financeiro escaneado, print de painel, gráfico de paper.
- Contagem. Estoque em prateleira, veículo em pátio, peça em linha de produção. A Elorian mostrou o modelo contando máquinas num canteiro de obra com timestamp de cada uma.
- Inspeção de vídeo curto. Câmera de segurança, vídeo de vistoria, UGC que precisa de legenda detalhada. O UGC-VideoCap é o teste dele.
- Rotulagem pra robótica. Separar um episódio em eventos de pick-and-place com timestamp é exatamente o caso de uso que a empresa mira primeiro.
Não vale trocar (ainda):
- Documento com muito texto. PDF, nota fiscal, contrato. Aí o problema é OCR, não raciocínio visual, e modelo dedicado tende a ser melhor e mais barato. A gente comparou isso no teste do Mistral OCR 4.
- Vídeo longo e raciocínio temporal pesado. No Video-MME v2 e no TOMATO, o Astra e o Sol ficam na frente.
- Fluxo com latência baixa. Olhar de novo custa tempo. Se o usuário está esperando na tela, teste o p95 antes.
- Qualquer coisa crítica em produção. É research preview. Sem SLA, sem histórico, sem avaliação independente.
A forma barata de decidir é a de sempre: separe 30 imagens reais do seu domínio com a resposta certa, rode no modelo atual e no Glimpse, e compare acerto e custo por tarefa. Benchmark de lab não conhece o seu caso.
Limitações e pontos de atenção
Os números são da Elorian. Todos. Com harness escolhido pela empresa e esforço máximo de raciocínio. Até eu publicar isso, nenhum avaliador independente reproduziu os resultados.
Alguns exemplos não são execução gravada. A página avisa que parte dos exemplos usa respostas de referência revisadas, e não traces do modelo rodando. O exemplo do pneu, por exemplo, é explicitamente uma resposta qualitativa, não uma simulação.
Gasta token pra olhar de novo. A empresa admite que a revisão visual cuidadosa consome tempo e tokens. Preço baixo por token não garante conta baixa.
Saída só em texto. Ele não gera imagem nem devolve ação pra robô. Controle direto de robô está listado como trabalho futuro.
Privacidade. Imagem de cliente, documento com rosto, vídeo de câmera interna: tudo isso sai da sua infra. Mascare ou anonimize antes de mandar, como faria com qualquer API.
FAQ rápido
O que é um VLM? VLM, ou vision language model, é um modelo de linguagem que aceita imagem (e às vezes vídeo) como entrada. A imagem vira tokens por um encoder visual e entra no contexto junto com o texto. A diferença do Glimpse é voltar à imagem durante o raciocínio, em vez de usá-la só uma vez no começo.
O Elorian Glimpse é melhor que o GPT-6 Astra? Em parte. Pelos números da própria Elorian, ganha em gráfico científico, legenda de vídeo curto, contagem no FSC-147 e robótica no WGO Bench, e empata no ERQA. Perde nos outros seis testes com nota do Astra, principalmente vídeo longo e raciocínio temporal. E custa cerca de 94% menos.
Quanto custa o Glimpse? US$ 0,60 por milhão de tokens de entrada e US$ 3 por milhão de saída, segundo a Elorian. É mais barato que o Gemini 3.8 Flash no preço introdutório. Mas como o modelo revisita a imagem, pode gastar mais tokens por tarefa. Meça o custo por tarefa resolvida.
Posso usar o Glimpse em produção? Pode testar, mas é research preview: sem SLA e sem avaliação independente ainda. Use em fluxo assíncrono, com fallback pra outro modelo e um eval com dados reais do seu domínio antes de qualquer decisão.
Conclusão
O Elorian Glimpse não ganhou a tabela. Ganhou um argumento: um modelo menor e bem mais barato chega perto dos maiores em visão porque volta pra olhar a evidência, em vez de confiar na própria descrição.
Se a tese se sustentar em avaliação independente, o próximo passo dos VLMs não é encoder maior. É raciocínio que consulta a imagem como consulta uma ferramenta. E aí contagem, leitura de gráfico e inspeção de vídeo deixam de ser os lugares onde LLM com visão quebra em produção.
Até lá, trate como trataria qualquer research preview: teste no seu caso, meça custo por tarefa e não troque nada no caminho crítico pela tabela do lab. Se o seu caso é documento, e não imagem, o comparativo do Mistral OCR 4 é o próximo passo.
{AI Engineer} — apaixonado por Laravel, arquitetura de software e construir produtos com impacto. Compartilho aqui tutoriais, descobertas e reflexões sobre o dia a dia de engenharia.
Conteúdo é o que não falta. Falta quem desembaralhe: o que importa agora é como implementar do jeito certo. No Clã você tem isso ao vivo, toda semana, com quem já filtrou o ruído.
Entrar no Clã