EmbeddingGemma 2: o embedding open source do Google que busca texto dentro de imagem
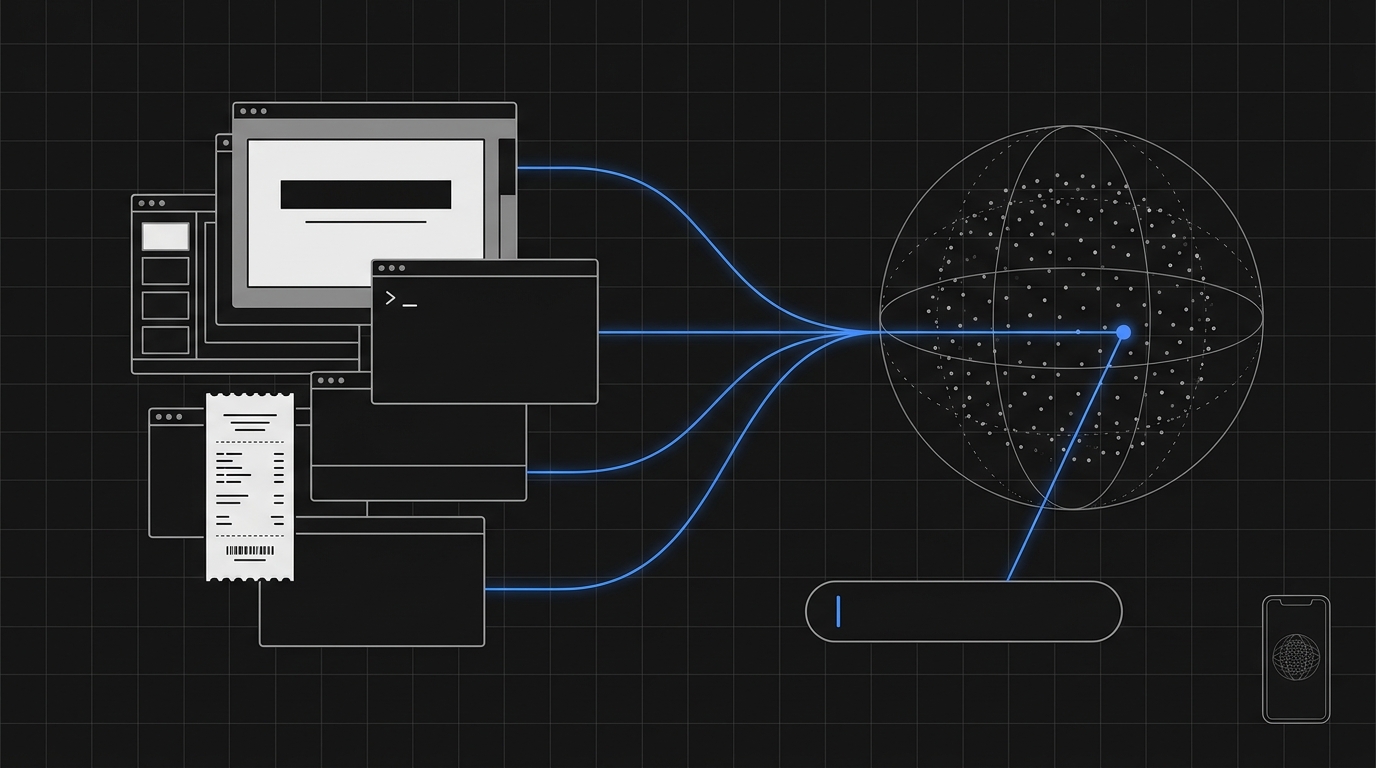
Você tem mil screenshots, slides e PDFs escaneados.
E a única forma de buscar dentro deles é rodar OCR em tudo antes.
O Google acabou de soltar o EmbeddingGemma 2: um embedding de 740M parâmetros, Apache 2.0, que coloca imagem e texto no mesmo espaço vetorial e roda até no celular. Isso abre uma pergunta bem prática pra quem constrói busca e RAG: dá pra pular o OCR e procurar texto direto na imagem?
Neste post eu te mostro o que o modelo é de fato (com os números do model card, não do hype), monto um indexador de screenshots com sentence-transformers + pgvector, comparo com o Gemini Embedding 2 e deixo claro onde o OCR continua sendo obrigatório.
Se você ainda não tem claro o que é um embedding, começa pelo nosso guia de embeddings. Aqui eu parto do princípio que você já sabe.
TL;DR
- O que é: embedding open-weights e nativamente multimodal do Google DeepMind. Texto, código, imagem, vídeo e áudio viram vetores no mesmo espaço de 768 dimensões.
- Stack/Modelos: Python,
sentence-transformers,transformers, PostgreSQL + pgvector. Também roda em Ollama, llama.cpp, MLX, vLLM, transformers.js e LiteRT. - Custo/Acesso: gratuito, Apache 2.0, pesos no Hugging Face e no Kaggle.
- Link útil: model card no Hugging Face e anúncio oficial.
O que é o EmbeddingGemma 2 e o que mudou da versão 1
O anúncio saiu em 6 de outubro de 2026, assinado por pesquisadores do Google DeepMind. O EmbeddingGemma 1 era só texto e, segundo o Google, passou de 20 milhões de downloads.
A versão 2 muda de categoria.
Ela é construída sobre a arquitetura do Gemma 4 e, nas palavras do próprio Google, "a partir da mesma tecnologia dos modelos Gemini Embedding". O que importa pra você:
- 740M parâmetros no total, só que modulares. O model card quebra assim: 130M de backbone de texto + 140M de embedder (os 270M "de texto"), 170M de encoder de visão e 300M de encoder de áudio. Você carrega só o que usa: texto puro fica em 270M, texto + imagem em 440M.
- Um espaço vetorial único. Uma query em texto e uma foto caem no mesmo espaço de 768 dimensões. Dá pra comparar direto, sem modelo-ponte.
- Contexto de 8.192 tokens, 4x a versão 1. O contexto é compartilhado entre modalidades: uma imagem custa 280 tokens por padrão, um frame de vídeo 140, um segundo de áudio 25.
- Matryoshka: 768 dimensões nativas, truncáveis pra 512, 256 ou 128.
- Roda no celular. Quantizado num Pixel 11 Pro, o Google reporta cerca de 191 MB de RAM ativa só com texto e cerca de 567 MB com o modelo multimodal completo.
Nos benchmarks publicados no model card (todos reportados pelo Google, nenhum reproduzido de forma independente ainda), o salto mais visível é em código: MTEB Code foi de 68,76 pra 78,68. Em texto multilíngue praticamente empatou com a versão 1 (61,36 contra 61,15 no MTEB multilingual v2).
O número que mais interessa pra este post é outro: 67,84 de NDCG@5 no MMEB v2 VisDoc, a parte do benchmark que mede recuperação de documento visual. É o indício mais próximo de "esse modelo consegue achar uma página pela pergunta que você faz sobre ela".
Indício. Não prova. Já já eu explico a diferença.
E aqui vai a parte que separa quem lê release de quem coloca em produção: modelo novo de embedding só vale alguma coisa depois que você roda no seu dado, com as suas queries, e mede. Esse ciclo de pegar o lançamento da semana, testar no dado real e decidir com número na mão é o que a gente faz toda semana, ao vivo, no Clã Beer and Code, com gente construindo junto em vez de cada um apanhando sozinho do mesmo bug.
Buscar texto dentro de imagem sem OCR: como funciona num espaço vetorial único
O pipeline clássico de busca em imagem com texto é assim:
- Roda OCR na imagem.
- Pega o texto extraído.
- Gera embedding desse texto.
- Indexa.
Funciona. Mas tem três custos escondidos: um modelo a mais pra manter, erro de OCR que vira erro de busca, e toda a informação que não é texto (layout, gráfico, cor, ícone, aquela setinha vermelha no print do bug) jogada fora.
Com um embedding multimodal, o pipeline vira:
- Gera embedding da imagem.
- Indexa.
Na hora da busca, você gera o embedding da pergunta em texto e procura o vizinho mais próximo. Como imagem e texto foram treinados pra cair no mesmo espaço, "erro 500 no checkout" tende a ficar perto do screenshot que tem um stack trace de checkout.
O ponto honesto: o encoder de visão não "lê" a imagem como um OCR. Ele codifica o que viu num vetor. Texto grande, legível e semanticamente central (título de slide, mensagem de erro, nome de produto) tem boa chance de sobreviver nessa compressão. Texto miúdo, tabela densa, número de nota fiscal? Aí é aposta.
E tem um botão que muda muito esse jogo: o orçamento de tokens visuais. O model card permite configurar de 70 a 1.120 soft tokens por imagem. Mais tokens, mais detalhe fino preservado, mais latência. Pra texto dentro de imagem, você quer o teto.
Nenhuma fonte que eu encontrei avaliou especificamente "recuperar texto em screenshot sem OCR" com o EmbeddingGemma 2. Então o código abaixo é pra você testar no seu acervo, não uma promessa de que vai funcionar.
Código: indexando screenshots com EmbeddingGemma 2 e buscando por texto com pgvector
Se você precisa de um refresh sobre por que guardar vetor no Postgres, temos um post sobre banco de dados vetorial. Aqui vamos direto pro código.
Pré-requisitos
- Python 3.10+
- PostgreSQL com a extensão pgvector instalada
- Uma pasta
screenshots/com PNGs ou JPGs
pip install -U sentence-transformers transformers pillow "psycopg[binary]" pgvector
Passo 1: carregar o modelo só com texto + visão
Sem áudio, o modelo cai de 740M pra 440M parâmetros. Em memória isso faz diferença.
import torch
from sentence_transformers import SentenceTransformer

# bfloat16 na GPU que suporta; float32 no resto (inclusive na maioria das CPUs).
# NUNCA float16: o model card avisa que devolve NaN ou embedding degradado sem erro nenhum.
dtype = torch.bfloat16 if torch.cuda.is_available() and torch.cuda.is_bf16_supported() else torch.float32

model = SentenceTransformer(
    "google/embeddinggemma-2",
    config_kwargs={"audio_config": None},   # desliga o encoder de áudio (440M)
    model_kwargs={"torch_dtype": dtype},
)

# Orçamento máximo de tokens visuais: preserva mais detalhe fino (texto pequeno)
IMG_KWARGS = {"image": {"max_soft_tokens": 1120}}
Aquele aviso do float16 não é detalhe. É o tipo de bug que não estoura exceção, só piora a busca em silêncio, e você passa uma semana culpando o pgvector.
Passo 2: criar a tabela e indexar as imagens
from pathlib import Path
import psycopg
from pgvector.psycopg import register_vector

conn = psycopg.connect("postgresql://localhost/busca", autocommit=True)
conn.execute("CREATE EXTENSION IF NOT EXISTS vector")
register_vector(conn)

conn.execute("""
    CREATE TABLE IF NOT EXISTS screenshots (
        id        bigserial PRIMARY KEY,
        path      text UNIQUE NOT NULL,
        embedding vector(768) NOT NULL
    )
""")
conn.execute("""
    CREATE INDEX IF NOT EXISTS screenshots_embedding_hnsw
    ON screenshots USING hnsw (embedding vector_cosine_ops)
""")

paths = sorted(p for p in Path("screenshots").iterdir() if p.suffix.lower() in {".png", ".jpg", ".jpeg"})

# Imagem entra num dict {"image": ...}: aceita caminho, URL ou PIL.Image.
# Imagem NÃO leva prefixo de tarefa; prefixo é só pra texto.
embeddings = model.encode(
    [{"image": str(p)} for p in paths],
    batch_size=8,
    normalize_embeddings=True,
    processing_kwargs=IMG_KWARGS,
    show_progress_bar=True,
)

with conn.cursor() as cur:
    for path, emb in zip(paths, embeddings):
        cur.execute(
            """
            INSERT INTO screenshots (path, embedding) VALUES (%s, %s)
            ON CONFLICT (path) DO UPDATE SET embedding = EXCLUDED.embedding
            """,
            (str(path), emb),
        )

print(f"{len(paths)} imagens indexadas")
Passo 3: buscar por texto
A query usa o prompt SearchQuery, que aplica o prefixo task: search result | query: ... definido no model card. Sem prefixo funciona, mas o próprio Google avisa que a qualidade cai.
def buscar(pergunta: str, k: int = 5):
    q = model.encode(pergunta, prompt_name="SearchQuery", normalize_embeddings=True)
    return conn.execute(
        """
        SELECT path, 1 - (embedding <=> %s) AS score
        FROM screenshots
        ORDER BY embedding <=> %s
        LIMIT %s
        """,
        (q, q, k),
    ).fetchall()

for path, score in buscar("erro de timeout na tela de pagamento"):
    print(f"{score:.3f}  {path}")
Pronto. Uma pergunta em texto, um ranking de imagens. Sem OCR no meio.
Passo 4: medir antes de acreditar
Agora a parte que quase ninguém faz. Separa umas 30 perguntas em que você sabe qual screenshot é a resposta e mede quantas vezes ela aparece no top 5.
casos = [
    ("erro de timeout na tela de pagamento", "screenshots/checkout-timeout.png"),
    ("slide com a meta de receita do Q3", "screenshots/board-q3-slide-07.png"),
    # ... mais 28 casos do seu acervo real
]

acertos = sum(
    any(path == esperado for path, _ in buscar(pergunta, k=5))
    for pergunta, esperado in casos
)
print(f"recall@5: {acertos / len(casos):.0%}")
Roda isso de novo com max_soft_tokens em 280 (o padrão) e depois em 1120. Roda de novo com o pipeline de OCR + embedding de texto. Agora você tem número pra decidir, não opinião.
Dica de armazenamento: se o recall se mantiver, teste truncar pra 256 dimensões (truncate_dim=256 no encode e vector(256) na tabela). O model card mostra perda pequena em imagem (MIEB lite de 64,64 pra 63,13) com 3x menos espaço. Já 128 dimensões derrubam o multimodal com força (MMEB v2 geral de 59,01 pra 45,65), então eu não iria pra lá com imagem.
Não só acompanhe as novidades — domine. Engenharia de IA na prática, ao vivo, toda semana, na maior comunidade do Brasil.
Entrar no ClãEmbeddingGemma 2 vs Gemini Embedding 2: open no seu servidor ou API do Google
O Google tem os dois. O Gemini Embedding 2 saiu em preview em 10 de março de 2026 e virou GA em abril. É fechado, roda via Gemini API e Vertex AI.
E tem um terceiro jogador que vale conhecer: a Perplexity publicou em 7 de outubro a família pplx-embed-v2-late, com pesos abertos no Hugging Face, focada em texto e imagem (inclusive página de PDF renderizada, sem OCR).
| EmbeddingGemma 2 | Gemini Embedding 2 | pplx-embed-v2-late 0.6B | |
|---|---|---|---|
| Acesso | Pesos abertos, Apache 2.0 | API fechada (Gemini API / Vertex AI) | Pesos abertos no Hugging Face |
| Onde roda | Seu servidor, notebook, celular, navegador | Só na nuvem do Google | Seu servidor |
| Modalidades | Texto, código, imagem, vídeo, áudio | Texto, imagem, vídeo, áudio, PDF | Texto e imagem |
| Formato do vetor | 1 vetor por input | 1 vetor por input | 1 vetor de 128 dims por token (late interaction) |
| Dimensões | 768 (até 128) | 3.072 padrão (128 a 3.072) | 128 por token |
| Contexto | 8.192 tokens | 8.192 tokens, até 6 imagens por request | n/d no anúncio |
| Custo | Seu hardware | US$ 0,20/M tokens de texto, US$ 0,45/M de imagem | Seu hardware |
Fontes da tabela: model card do EmbeddingGemma 2, docs e preços do Gemini Embedding 2, e o anúncio da Perplexity.
Como eu decidiria:
- Dado sensível ou volume alto (screenshot interno, nota fiscal de cliente, print de tela com dado pessoal): EmbeddingGemma 2. O dado não sai do seu servidor e o custo marginal por imagem é zero depois que a máquina existe.
- Busca no celular ou offline: EmbeddingGemma 2, sem concorrência nesta tabela.
- Time pequeno, sem GPU, querendo o máximo de qualidade com zero operação: Gemini Embedding 2. A conta de US$ 0,00012 por imagem é difícil de bater quando você não quer cuidar de infraestrutura.
- Busca em documento visual denso, onde cada detalhe conta: vale testar o pplx-embed-v2-late. Late interaction guarda um vetor por token, o que costuma ajudar em detalhe fino, mas cobra em armazenamento e não encaixa no esquema "uma linha, um vetor" do pgvector sem adaptação.
Um aviso que vale pra qualquer escolha: espaços vetoriais de modelos diferentes não conversam. Trocar de embedding significa reindexar tudo. Escolhe com eval, não com hype, porque a troca custa caro.
E não dá pra comparar os benchmarks entre si. O Google publica MMEB, a Perplexity publica ViDoRe, e nenhum dos dois roda no benchmark do outro nos anúncios. Mais um motivo pro Passo 4 lá em cima.
Onde ainda vale manter o OCR no pipeline
Embedding multimodal encontra. OCR extrai. São trabalhos diferentes.
Mantenha o OCR quando:
- Você precisa do texto, não só da imagem. Pegar o valor total, o CNPJ, a data de vencimento de uma nota fiscal é extração, não busca. Embedding nenhum te devolve o número.
- A busca é por string exata. Número de pedido, código de erro, hash de commit. Vetor é bom em semântica e ruim em literal. Aqui OCR + busca textual (ou busca híbrida) ganha fácil.
- Documento longo e denso. Contrato de 40 páginas escaneado não cabe numa imagem só, e texto miúdo é exatamente onde a compressão do encoder de visão perde informação.
- Auditoria. Se alguém precisa ver por que aquele documento apareceu, um trecho de texto destacado explica. Um score de cosseno, não.
- RAG que vai citar o conteúdo. O LLM precisa do texto pra responder. Você pode buscar pela imagem, mas no fim alguém vai ter que ler.
Pra esse lado do pipeline, o nosso post sobre o Mistral OCR 4 mostra o estado da arte em leitura de PDF.
O desenho que eu acho mais sensato pra produção hoje é híbrido: embedding da imagem pra recall amplo e barato, OCR rodando só nos top-k que de fato vão pro LLM ou pro usuário. Você paga OCR em 5 imagens por busca, não em 1 milhão na indexação.
Limitações e pontos de atenção
- Nada aqui foi validado de forma independente. Todos os números deste post vêm do Google ou da Perplexity.
- Treino com corte em janeiro de 2025. Interface, produto ou meme novo depois disso pode virar ruído.
- Modelo só pré-treinado. O model card diz que não tem safety tuning nem moderação. Filtro de conteúdo é responsabilidade sua.
- Privacidade continua sendo problema. Indexar screenshot de tela é indexar senha, token e dado de cliente que apareceu no print. Rodar local resolve o vazamento pra terceiros, não o acesso indevido dentro de casa. Controle quem consulta o índice.
- Contexto é dividido entre modalidades. Com 1.120 tokens por imagem, cabem só umas 7 imagens num input intercalado. Pra indexar screenshot, uma imagem por vetor é o caminho.
FAQ rápido
Posso usar o EmbeddingGemma 2 comercialmente? Pode. A licença é Apache 2.0, descrita pelo próprio Google como comercialmente permissiva. Respeite também a política de uso proibido do Gemma, que o model card referencia.
Roda em CPU?
Roda, em float32. Pra texto puro, carregando só os 270M, fica bem leve. Com imagem é viável pra indexação em lote, mas GPU com bfloat16 acelera muito. float16 não, nunca: devolve NaN em silêncio.
Funciona com português? O model card fala em mais de 100 idiomas e o resultado no MTEB multilingual v2 é de 61,36. Para texto em português dentro de imagem não há número publicado. Teste no seu acervo.
Preciso reindexar se eu já uso o EmbeddingGemma 1? Sim. É outro modelo, outro espaço vetorial. Vetores das duas versões não são comparáveis, assim como acontece entre o Gemini Embedding 001 e o 2.
Conclusão
O EmbeddingGemma 2 é o primeiro embedding multimodal open source do Google, cabe no celular, e coloca screenshot e pergunta em texto no mesmo espaço vetorial. Isso torna "buscar dentro da imagem sem OCR" algo que você testa numa tarde, com Postgres e quarenta linhas de Python.
Mas testar é a palavra.
O próximo passo dessa tecnologia é o embedding virar a camada de recall barato e o OCR (ou um VLM) virar a camada de precisão, só no que importa. Quem montar esse híbrido com eval de verdade vai ter busca melhor e conta menor.
Se for começar agora, revisa a base no nosso guia de embeddings e escolhe onde guardar os vetores com o post de banco de dados vetorial.
{AI Engineer} — apaixonado por Laravel, arquitetura de software e construir produtos com impacto. Compartilho aqui tutoriais, descobertas e reflexões sobre o dia a dia de engenharia.
Conteúdo é o que não falta. Falta quem desembaralhe: o que importa agora é como implementar do jeito certo. No Clã você tem isso ao vivo, toda semana, com quem já filtrou o ruído.
Entrar no Clã